# Die Zweite Meinung
> Der Blog von Andreas Lezgus, CTO im Sicherheitsbereich des Bundes: KI-Governance, digitale Souveränität und Technologiestrategie für regulierte Organisationen.
Public Ghost content for AI and LLM tooling. This file includes a bounded export of public pages first, then recent public posts.
Append `.md` to any post or page URL to get the content in Markdown (for example, `/example-post.md`).
## Pages
### Tags
URL: https://www.lezgus.de/tags/
Last updated: 2026-01-07T16:29:11.000Z
_No content available._
### Account
URL: https://www.lezgus.de/account/
Last updated: 2025-12-24T14:38:48.000Z
_No content available._
### Anmelden
URL: https://www.lezgus.de/signin/
Last updated: 2026-01-06T14:21:50.000Z
_No content available._
### Kontakt
URL: https://www.lezgus.de/contact/
Last updated: 2025-12-28T17:30:15.000Z
Beginne den Kontakt...
### Impressum
URL: https://www.lezgus.de/impressum/
Last updated: 2026-04-29T15:00:40.000Z
> Kurz, klar, gesetzlich: Impressum und Kontaktaufnahme.
Impressum und Kontaktaufnahme
**Angaben gemäß § 5 DDG**
## Verantwortlich für den Inhalt
Andreas Lezgus
Emsdettener Strasse 26A
48565 Steinfurt
Deutschland
**Kontakt:**
E-Mail: info@lezgus.de
**Online-Profile:**
LinkedIn: https://www.linkedin.com/in/andreaslezgus
Website: [https://www.lezgus.de.](https://www.lezgus.de/)
## Berufliche Angaben
**Hinweis:** Dieser Blog "Die Zweite Meinung" ist ein privates, unabhängiges Online-Angebot und steht in keiner Verbindung mit meinem Arbeitgeber dem Bundeskriminalamt. Die hier geäußerten Meinungen und Analysen sind ausschließlich persönlicher Natur und geben nicht die Position oder Ansicht des Bundeskriminalamtes wieder.
## Verantwortlich für redaktionelle Inhalte
Verantwortlich für journalistisch-redaktionelle Inhalte gemäß § 18 Abs. 2 MStV:
Andreas Lezgus
Emsdettener Strasse 26A
48565 Steinfurt
Deutschland
## EU-Streitschlichtung
Die Europäische Kommission stellt eine Plattform zur Online-Streitbeilegung (OS) bereit: [https://ec.europa.eu/consumers/odr/](https://ec.europa.eu/consumers/odr/?ref=lezgus.de)
Meine E-Mail-Adresse finden Sie oben im Impressum.
## Verbraucherstreitbeilegung / Universalschlichtungsstelle
Ich bin nicht bereit oder verpflichtet, an Streitbeilegungsverfahren vor einer Verbraucherschlichtungsstelle teilzunehmen.
---
## Haftungsausschluss (Disclaimer)
### Haftung für Inhalte
Die Inhalte meiner Seiten wurden mit größter Sorgfalt erstellt. Für die Richtigkeit, Vollständigkeit und Aktualität der Inhalte kann ich jedoch keine Gewähr übernehmen. Als Diensteanbieter bin ich gemäß § 7 Abs.1 DGG für eigene Inhalte auf diesen Seiten nach den allgemeinen Gesetzen verantwortlich. Nach §§ 8 bis 10 DGG bin ich als Diensteanbieter jedoch nicht verpflichtet, übermittelte oder gespeicherte fremde Informationen zu überwachen oder nach Umständen zu forschen, die auf eine rechtswidrige Tätigkeit hinweisen. Verpflichtungen zur Entfernung oder Sperrung der Nutzung von Informationen nach den allgemeinen Gesetzen bleiben hiervon unberührt. Eine diesbezügliche Haftung ist jedoch erst ab dem Zeitpunkt der Kenntnis einer konkreten Rechtsverletzung möglich. Bei Bekanntwerden von entsprechenden Rechtsverletzungen werde ich diese Inhalte umgehend entfernen.
### Meinungsäußerungen und Analysen
Die in diesem Blog veröffentlichten Beiträge stellen persönliche Meinungen, Analysen und Bewertungen dar, die auf über 40 Jahren Berufserfahrung im öffentlichen Dienst basieren. Sie dienen der Information und Diskussion, nicht der Beratung für spezifische Entscheidungen.
**Wichtiger Hinweis:** Die Inhalte dieses Blogs geben ausschließlich die private Meinung des Autors wieder und stellen keine offiziellen Aussagen oder Positionen des Bundeskriminalamtes oder anderer Behörden dar.
### Haftung für Links
Mein Angebot enthält Links zu externen Websites Dritter, auf deren Inhalte ich keinen Einfluss haben. Deshalb kann ich für diese fremden Inhalte auch keine Gewähr übernehmen. Für die Inhalte der verlinkten Seiten ist stets der jeweilige Anbieter oder Betreiber der Seiten verantwortlich. Die verlinkten Seiten wurden zum Zeitpunkt der Verlinkung auf mögliche Rechtsverstöße überprüft. Rechtswidrige Inhalte waren zum Zeitpunkt der Verlinkung nicht erkennbar. Eine permanente inhaltliche Kontrolle der verlinkten Seiten ist jedoch ohne konkrete Anhaltspunkte einer Rechtsverletzung nicht zumutbar. Bei Bekanntwerden von Rechtsverletzungen werde ich derartige Links umgehend entfernen.
---
## Urheberrecht
### Eigene Inhalte
Die durch den Seitenbetreiber erstellten Inhalte und Werke auf diesen Seiten unterliegen dem deutschen Urheberrecht. Die Vervielfältigung, Bearbeitung, Verbreitung und jede Art der Verwertung außerhalb der Grenzen des Urheberrechtes bedürfen der schriftlichen Zustimmung des jeweiligen Autors bzw. Erstellers. Downloads und Kopien dieser Seite sind nur für den privaten, nicht kommerziellen Gebrauch gestattet.
Soweit die Inhalte auf dieser Seite nicht vom Betreiber erstellt wurden, werden die Urheberrechte Dritter beachtet. Insbesondere werden Inhalte Dritter als solche gekennzeichnet. Sollten Sie trotzdem auf eine Urheberrechtsverletzung aufmerksam werden, bitte ich um einen entsprechenden Hinweis. Bei Bekanntwerden von Rechtsverletzungen werde ich derartige Inhalte umgehend entfernen.
### Lizenzhinweise
Soweit nicht anders angegeben, stehen alle Texte, Grafiken und Analysen auf diesem Blog unter:
**Creative Commons Lizenz:** [CC BY-NC-ND 4.0](https://creativecommons.org/licenses/by-nc-nd/4.0/deed.de?ref=lezgus.de)
(Namensnennung - Nicht kommerziell - Keine Bearbeitungen 4.0 International)
**Das bedeutet:**
- ✓ Sie dürfen die Inhalte teilen und verbreiten
- ✓ Namensnennung erforderlich: "Andreas Lezgus, Die Zweite Meinung"
- ✗ Keine kommerzielle Nutzung ohne Zustimmung
- ✗ Keine Bearbeitungen oder Ableitungen ohne Zustimmung
Für andere Nutzungsarten kontaktieren Sie mich bitte.
---
## Hinweise zu Affiliate-Links und Werbung
**Transparenz:**
Derzeit werden auf diesem Blog keine Affiliate-Links verwendet und keine bezahlte Werbung geschaltet. Sollte sich dies in Zukunft ändern, werden entsprechende Links eindeutig als solche gekennzeichnet (z.B. mit \* oder "Anzeige").
**Produktempfehlungen:**
Empfehlungen für Software, Tools oder Dienstleistungen basieren ausschließlich auf persönlicher Erfahrung und Überzeugung. Es besteht keine finanzielle Verbindung zu erwähnten Anbietern, sofern nicht explizit anders gekennzeichnet.
---
## Newsletter und Mitgliedschaften
### Newsletter-Versand
Der Newsletter-Versand erfolgt über die integrierte Ghost-Funktionalität. Weitere Informationen finden Sie in meiner [Datenschutzerklärung](https://www.lezgus.de/datenschutz/).
### Mitgliedschaften
Die Abwicklung von Mitgliedschaften im speziellen Abonnements erfolgt über Stripe Payments. Durch den Abschluss einer Mitgliedschaft kommen Sie ein Vertragsverhältnis ein, das die [Allgemeinen Geschäftsbedingungen](https://stripe.com/?ref=lezgus.de) und die [Datenschutzerklärung](https://www.lezgus.de/datenschutz/) einschließt.
---
## Social Media
### LinkedIn
Ich bin auf LinkedIn präsent. Beachten Sie, dass beim Besuch meiner LinkedIn-Seite die Datenschutzrichtlinien von LinkedIn gelten: [LinkedIn Privacy Policy](https://www.linkedin.com/legal/privacy-policy?ref=lezgus.de)
### Kontakt über Social Media
Sie können mich gerne über LinkedIn kontaktieren. Bitte beachten Sie, dass Nachrichten über Social-Media-Plattformen den Datenschutzbestimmungen der jeweiligen Plattform unterliegen.
---
## Technische Umsetzung
**Blog-Software:**
Diese Website wird mit Ghost betrieben, einer Open-Source-Publishing-Plattform.
**Hosting:**
Magic Places: Jannis Fedoruk-Betschki
Wiesingerstraße 2, 4820 Bad Ischl, Österreich
Details zur Datenverarbeitung finden Sie in meiner [Datenschutzerklärung](https://www.lezgus.de/datenschutz/).
---
## Kontakt und Feedback
Ich freue mich über Feedback, Anregungen und konstruktive Kritik!
**Bevorzugte Kontaktkanäle:**
- E-Mail: info@lezgus.de
- LinkedIn: www.linkedin.com/in/andreaslezgus
- Newsletter-Antwort: Antworten Sie direkt auf meinen Newsletter
**Reaktionszeit:**
Ich bemühe mich, Anfragen innerhalb von 3-5 Werktagen zu beantworten. Bitte haben Sie Verständnis dafür, dass dies ein persönlich betriebener Blog neben der Haupttätigkeit ist.
---
## Barrierefreiheit
Ich bemühe mich, diese Website nach den Richtlinien der WCAG 2.1 (Level AA) barrierefrei zu gestalten. Sollten Sie auf Barrieren stoßen, kontaktieren Sie mich bitte, damit wir Verbesserungen vornehmen können.
**Aktuelle Maßnahmen:**
- Semantisches HTML
- Alt-Texte für Bilder
- Ausreichende Farbkontraste
- Responsive Design für mobile Geräte
- Klare Navigationsstruktur
---
## Änderungen des Impressums
Dieses Impressum kann jederzeit geändert werden, um rechtlichen Anforderungen zu entsprechen oder Änderungen meines Angebotes widerzuspiegeln. Die aktuelle Version ist stets unter abrufbar.
**Letzte Aktualisierung:** 01\. April 2026
### Datenschutz
URL: https://www.lezgus.de/datenschutz/
Last updated: 2026-04-29T15:00:18.000Z
> "Die Zweite Meinung" steht für Transparenz und Vertrauen.
Datenschutz steht für Transparenz und Vertrauen
Ich nehme den Schutz Deiner persönlichen Daten sehr ernst. Diese Datenschutzerklärung soll transparent und verständlich sein. Solltest Du Fragen haben oder Unterstützung bei der Ausübung Deiner Rechte benötigen, zögere nicht, mich unter info@lezgus.de zu kontaktieren.
**Kernprinzipien meiner Datenverarbeitung:**
✓ **Datensparsamkeit** \- Ich erhebe nur Daten, die wirklich benötigt werden
✓ **Zweckbindung** \- Daten werden nur für den angegebenen Zweck verwendet
✓ **Sicherheit** \- Deine Daten sind durch moderne Verschlüsselung geschützt
✓ **Transparenz** \- Du habst jederzeit Kontrolle über Deine Daten
✓ **EU-Standards** \- Alle Daten werden in der EU verarbeitet und gespeichert
**Letzte Aktualisierung:** 01\. April 2026
## 1\. Verantwortlicher
Verantwortlich für die Datenverarbeitung auf dieser Website ist:
Andreas Lezgus
Blog: Die Zweite Meinung
Emsdettener Straße 26A
48565 Steinfurt
Deutschland
E-Mail: info@lezgus.de
## 2\. Allgemeines zur Datenverarbeitung
### 2.1 Umfang der Verarbeitung personenbezogener Daten
Ich verarbeite personenbezogene Daten meiner Nutzer grundsätzlich nur, soweit dies zur Bereitstellung einer funktionsfähigen Website sowie meiner Inhalte und Leistungen erforderlich ist. Die Verarbeitung personenbezogener Daten erfolgt regelmäßig nur nach Einwilligung des Nutzers. Eine Ausnahme gilt in solchen Fällen, in denen eine vorherige Einholung einer Einwilligung aus tatsächlichen Gründen nicht möglich ist und die Verarbeitung der Daten durch gesetzliche Vorschriften gestattet ist.
### 2.2 Rechtsgrundlage für die Verarbeitung
Soweit ich für Verarbeitungsvorgänge personenbezogener Daten eine Einwilligung der betroffenen Person einhole, dient Art. 6 Abs. 1 lit. a EU-Datenschutzgrundverordnung (DSGVO) als Rechtsgrundlage.
Bei der Verarbeitung personenbezogener Daten, die zur Erfüllung eines Vertrages erforderlich ist, dient Art. 6 Abs. 1 lit. b DSGVO als Rechtsgrundlage. Dies gilt auch für Verarbeitungsvorgänge, die zur Durchführung vorvertraglicher Maßnahmen erforderlich sind.
Soweit eine Verarbeitung zur Wahrung eines berechtigten Interesses von mir oder eines Dritten erforderlich ist und die Interessen, Grundrechte und Grundfreiheiten des Betroffenen das erstgenannte Interesse nicht überwiegen, dient Art. 6 Abs. 1 lit. f DSGVO als Rechtsgrundlage.
### 2.3 Datenlöschung und Speicherdauer
Die personenbezogenen Daten der betroffenen Person werden gelöscht oder gesperrt, sobald der Zweck der Speicherung entfällt. Eine Speicherung kann darüber hinaus erfolgen, wenn dies durch europäische oder nationale Rechtsvorschriften vorgesehen wurde. Eine Sperrung oder Löschung der Daten erfolgt auch dann, wenn eine durch die genannten Normen vorgeschriebene Speicherfrist abläuft, es sei denn, dass eine Erforderlichkeit zur weiteren Speicherung der Daten für einen Vertragsabschluss oder eine Vertragserfüllung besteht.
## 3\. Bereitstellung der Website und Erstellung von Logfiles
### 3.1 Beschreibung und Umfang
Bei jedem Aufruf meiner Website erfasst mein Hosting-Provider automatisch Daten und Informationen vom Computersystem des aufrufenden Rechners.
Folgende Daten werden hierbei erhoben:
- Browsertyp und Browserversion
- Verwendetes Betriebssystem
- Referrer URL (die zuvor besuchte Seite)
- Hostname des zugreifenden Rechners
- Uhrzeit der Serveranfrage
- IP-Adresse (anonymisiert)
Die Daten werden ebenfalls in den Logfiles des Systems gespeichert. Eine Speicherung dieser Daten zusammen mit anderen personenbezogenen Daten des Nutzers findet nicht statt.
### 3.2 Rechtsgrundlage
Rechtsgrundlage für die vorübergehende Speicherung der Daten und der Logfiles ist Art. 6 Abs. 1 lit. f DSGVO (berechtigtes Interesse an der Sicherstellung der Funktionsfähigkeit der Website).
### 3.3 Zweck
Die vorübergehende Speicherung der IP-Adresse durch das System ist notwendig, um eine Auslieferung der Website an den Rechner des Nutzers zu ermöglichen. Hierfür muss die IP-Adresse des Nutzers für die Dauer der Sitzung gespeichert bleiben. Die Speicherung in Logfiles erfolgt, um die Funktionsfähigkeit der Website sicherzustellen und die Sicherheit meiner informationstechnischen Systeme zu gewährleisten.
### 3.4 Speicherdauer
Die Daten werden gelöscht, sobald sie für die Erreichung des Zweckes ihrer Erhebung nicht mehr erforderlich sind. Im Falle der Erfassung der Daten zur Bereitstellung der Website ist dies der Fall, wenn die jeweilige Sitzung beendet ist. Logfiles werden nach spätestens 7 Tagen gelöscht.
## 4\. Newsletter und E-Mail-Kommunikation
### 4.1 Newsletter-Abonnement
Wenn Du meinen Newsletter abonnierst, verwende ich die von Dir angegebenen Daten ausschließlich für diesen Zweck oder um Dich über relevante Umstände im Zusammenhang damit zu informieren.
**Verarbeitete Daten:**
- E-Mail-Adresse (erforderlich)
- Name (optional, falls angegeben)
- Zeitpunkt der Anmeldung
- IP-Adresse zum Zeitpunkt der Anmeldung
**Rechtsgrundlage:** Art. 6 Abs. 1 lit. a DSGVO (Einwilligung)
**Zweck:** Versand von Newslettern mit Informationen über neue Blog-Artikel, Insights zu IT-Leadership und KI-Themen
**Double-Opt-In-Verfahren:** Ihre Newsletter-Anmeldung erfolgt im Double-Opt-In-Verfahren. Du erhältst nach der Anmeldung eine E-Mail, in der Du aufgefordert werden, Ihre Anmeldung zu bestätigen. Diese Bestätigung ist notwendig, damit sich niemand mit fremden E-Mail-Adressen anmelden kann.
**Widerruf:** Du kannst Deine Einwilligung zum Erhalt des Newsletters jederzeit mit Wirkung für die Zukunft widerrufen. Den Widerrufslink findest Du in jedem Newsletter oder Du kannst mich direkt kontaktieren.
### 4.2 Ghost Newsletter-System
Mein Newsletter wird über Ghost (Ghost Foundation) versendet. Ghost ist eine Open-Source-Publishing-Plattform.
**Verarbeitete Daten:**
- E-Mail-Adresse
- Newsletter-Interaktionen (Öffnungen, Klicks)
- Anmeldedatum
**Speicherort:** Meine Ghost-Installation wird in der Deutschland (EU) gehostet und unterliegt der DSGVO.
**Weitere Informationen:** [https://www.magicpages.co/datacenters/#infrastructure](https://www.magicpages.co/datacenters/?ref=lezgus.de#infrastructure)
## 5\. Mitgliedschaften und kostenpflichtige Inhalte
### 5.1 Mitgliedschaftsverwaltung
Wenn Du dich für eine Mitgliedschaft auf meiner Website registrierst, verarbeite ich folgende Daten:
**Verarbeitete Daten:**
- Name
- E-Mail-Adresse
- Gewählter Mitgliedschaftstyp
- Registrierungsdatum
- Mitgliedschaftsstatus (aktiv/inaktiv)
**Rechtsgrundlage:** Art. 6 Abs. 1 lit. b DSGVO (Vertragserfüllung)
**Zweck:**
- Verwaltung Deines Mitgliedschaftskontos
- Zugriff auf exklusive Inhalte
- Kommunikation über Deine Mitgliedschaft
**Speicherdauer:** Die Daten werden für die Dauer der Mitgliedschaft gespeichert und anschließend gemäß gesetzlicher Aufbewahrungsfristen (i.d.R. 10 Jahre für steuerrechtliche Zwecke) aufbewahrt.
### 5.2 Zahlungsabwicklung mit Stripe
Für die Abwicklung von Zahlungen (Mitgliedschaften, Spenden) nutze ich den Zahlungsdienstleister Stripe.
**Dienstleister:**
Stripe Payments Europe, Ltd.
1 Grand Canal Street Lower
Grand Canal Dock, Dublin, D02 H210
Irland
**Verarbeitete Daten:**
- Name
- E-Mail-Adresse
- Zahlungsdaten (Kreditkartennummer, Ablaufdatum, Prüfziffer)
- Rechnungsadresse
- Transaktionsdaten
**Wichtig:** Die Zahlungsdaten (Kreditkartendaten) werden ausschließlich von Stripe verarbeitet. Ich selbst speichere keine vollständigen Zahlungskartendaten. Stripe ist PCI-DSS Level 1 zertifiziert (höchster Sicherheitsstandard für Zahlungsdienstleister).
**Rechtsgrundlage:** Art. 6 Abs. 1 lit. b DSGVO (Vertragserfüllung)
**Zweck:** Sichere Abwicklung von Online-Zahlungen
**Datenübermittlung in Drittland:** Stripe kann Daten in die USA übertragen. Die Übermittlung erfolgt auf Basis der EU-Standardvertragsklauseln. Stripe ist zudem nach dem EU-U.S. Data Privacy Framework zertifiziert.
**Weitere Informationen:**
- [Stripe Privacy Policy](https://stripe.com/privacy?ref=lezgus.de)
- [Stripe GDPR Guide](https://stripe.com/guides/general-data-protection-regulation?ref=lezgus.de)
**Deine Rechte bei Stripe:** Du kannst Auskunft über die bei Stripe gespeicherten Daten anfordern, Berichtigung oder Löschung verlangen. Kontaktiere hierfür Stripe unter: privacy@stripe.com oder mich direkt.
## 6\. Cookies und lokale Speicherung
### 6.1 Verwendung von Cookies
Meine Website verwendet Cookies sowie die localStorage-Funktion des Browsers. Cookies sind Textdateien, die im Internetbrowser bzw. vom Internetbrowser auf dem Computersystem des Nutzers gespeichert werden. localStorage ist ein browserseitiger Speicher, der Daten lokal auf Ihrem Gerät ablegt.
**Arten von Cookies:**
**Technisch notwendige Cookies und lokale Speicherung (ohne Einwilligung):**
| Bezeichnung | Typ | Zweck | Speicherdauer |
| ----------------------- | ------------ | ------------------------------------------------------- | -------------------------------- |
| ghost-members-ssr | Cookie | Session-Cookie für Mitglieder-Authentifizierung | Sitzungsende |
| theme-preference | localStorage | Speicherung der gewählten Darstellung (Dark/Light Mode) | Dauerhaft (bis manuell gelöscht) |
| cookie-consent-accepted | localStorage | Speicherung, ob der Cookie-Hinweis bestätigt wurde | Dauerhaft (bis manuell gelöscht) |
Diese Technologien sind für den Betrieb der Website technisch erforderlich. Rechtsgrundlage: § 25 Abs. 2 TDDDG (technische Erforderlichkeit) in Verbindung mit Art. 6 Abs. 1 lit. f DSGVO (berechtigtes Interesse).
**Hinweis:** Die Speicherung der Dark/Light-Mode-Präferenz erfolgt ausschließlich lokal in Deinem Browser (localStorage). Es werden dabei keine Daten an meinen Server übertragen.
### 6.2 Cookie-Verwaltung
Du kannst Deine Cookie-Einstellungen jederzeit über Deinen Browser ändern. Die meisten Browser sind so eingestellt, dass sie Cookies automatisch akzeptieren. Du kannst das Speichern von Cookies jedoch deaktivieren oder Deinen Browser so einstellen, dass er Dich benachrichtigt, sobald Cookies gesendet werden. localStorage-Daten kannst Du über die Entwicklertools Deines Browsers oder die Browser-Einstellungen löschen.
### 6.3 Ghost Analytics
Ghost bietet integrierte, datenschutzfreundliche Analytics-Funktionen. Diese erfassen:
- Seitenaufrufe (anonymisiert)
- Leseverhalten (anonymisiert)
- Gerätetyp (aggregiert)
Es werden **keine** IP-Adressen gespeichert und **keine** personenbezogenen Daten erfasst. Die Daten werden ausschließlich für statistische Zwecke in aggregierter Form verwendet.
**Rechtsgrundlage:** Art. 6 Abs. 1 lit. f DSGVO (berechtigtes Interesse an der Verbesserung meines Angebots)
## 7\. Kontaktaufnahme und Kommentare
### 7.1 E-Mail-Kontakt
Wenn Du mich per E-Mail kontaktierst, werden Deine Angaben aus der E-Mail inklusive der von Dir dort angegebenen Kontaktdaten zwecks Bearbeitung der Anfrage und für den Fall von Anschlussfragen bei mir gespeichert.
**Rechtsgrundlage:** Art. 6 Abs. 1 lit. f DSGVO (berechtigtes Interesse an der Beantwortung Ihrer Anfrage)
**Speicherdauer:** Die Daten werden gelöscht, sobald die Bearbeitung Ihrer Anfrage abgeschlossen ist und keine gesetzlichen Aufbewahrungspflichten bestehen.
### 7.2 Kommentarfunktion
Falls auf meinem Blog eine Kommentarfunktion aktiviert wird, werden bei Abgabe eines Kommentars folgende Daten gespeichert:
- Name oder Pseudonym
- E-Mail-Adresse (nicht öffentlich)
- Kommentartext
- Zeitpunkt der Kommentarabgabe
- IP-Adresse (zur Spam-Prävention, 7 Tage)
**Rechtsgrundlage:** Art. 6 Abs. 1 lit. a DSGVO (Einwilligung durch aktive Kommentarabgabe)
**Speicherdauer:** Kommentare werden auf unbestimmte Zeit gespeichert, können aber jederzeit von Dir zur Löschung angefordert werden.
## 8\. Social Media und externe Inhalte
### 8.1 LinkedIn
Auf meiner Website findest Du Links zu meinem LinkedIn-Profil. Es handelt sich um einfache Verlinkungen (keine Plugins oder eingebetteten Inhalte). Erst wenn Du aktiv auf einen LinkedIn-Link klickst, wirst Du zu LinkedIn weitergeleitet. LinkedIn kann dann Daten über Deinen Besuch erfassen. Ich habe keinen Einfluss auf den Umfang der von LinkedIn erhobenen Daten.
**Weitere Informationen:** [LinkedIn Privacy Policy](https://www.linkedin.com/legal/privacy-policy?ref=lezgus.de)
### 8.2 Externe Medien
Externe Medien (z.B. YouTube-Videos) werden derzeit nicht eingebettet. Sollte ich in Zukunft externe Medien einbinden, werde ich sicherstellen, dass diese nur nach Ihrer ausdrücklichen Zustimmung geladen werden, um eine ungewollte Datenübertragung an Drittanbieter zu verhindern. Diese Datenschutzerklärung wird dann entsprechend aktualisiert.
## 9\. Hosting und technische Dienstleister
### 9.1 Webhosting
Diese Website wird gehostet bei:
Magic Pages: Jannis Fedoruk-Betschki
Wiesingerstraße 2, 4820 Bad Ischl
[https://www.magicpages.co](https://www.magicpages.co/?ref=lezgus.de)
**Verarbeitete Daten:** Alle Daten, die bei der Nutzung dieser Website anfallen (siehe Abschnitt 3)
**Rechtsgrundlage:** Art. 6 Abs. 1 lit. f DSGVO (berechtigtes Interesse an zuverlässigem und sicherem Webhosting)
**Auftragsverarbeitung:** Mit meinem Hosting-Provider besteht ein Auftragsverarbeitungsvertrag gemäß Art. 28 DSGVO.
**Serverstandort:** Deutschland (EU)
### 9.2 Content Delivery Network (CDN)
Derzeit wird kein separates Content Delivery Network (CDN) eingesetzt. Statische Inhalte werden direkt über den Hosting-Provider ausgeliefert. Sollte in Zukunft ein CDN eingesetzt werden, wird diese Datenschutzerklärung entsprechend aktualisiert.
**Rechtsgrundlage:** Art. 6 Abs. 1 lit. f DSGVO (berechtigtes Interesse an schneller Website-Performance)
## 10\. Datensicherheit
Ich verwende innerhalb des Website-Besuchs das verbreitete SSL-Verfahren (Secure Socket Layer) in Verbindung mit der jeweils höchsten Verschlüsselungsstufe, die von Ihrem Browser unterstützt wird. In der Regel handelt es sich dabei um eine 256-Bit-Verschlüsselung.
Ich bediene mich technischer und organisatorischer Sicherheitsmaßnahmen, um Ihre verwalteten Daten gegen zufällige oder vorsätzliche Manipulationen, Verlust, Zerstörung oder gegen den Zugriff unberechtigter Personen zu schützen. Meine Sicherheitsmaßnahmen werden entsprechend der technologischen Entwicklung fortlaufend verbessert.
**Meine Sicherheitsmaßnahmen umfassen:**
- SSL/TLS-Verschlüsselung für alle Datenübertragungen
- Regelmäßige Sicherheitsupdates
- Verschlüsselte Datenspeicherung
- Zugriffsbeschränkungen
- Regelmäßige Backups
- Firewall-Schutz
## 11\. Ihre Rechte als betroffene Person
### 11.1 Auskunftsrecht (Art. 15 DSGVO)
Du hast das Recht, von mir eine Bestätigung darüber zu verlangen, ob Dich betreffende personenbezogene Daten verarbeitet werden. Ist dies der Fall, hast Du ein Recht auf Auskunft über diese Daten und auf weitere Informationen (Verarbeitungszwecke, Kategorien der Daten, Empfänger, Speicherdauer).
### 11.2 Recht auf Berichtigung (Art. 16 DSGVO)
Du hast das Recht, die unverzügliche Berichtigung Dich betreffender unrichtiger personenbezogener Daten zu verlangen.
### 11.3 Recht auf Löschung (Art. 17 DSGVO)
Du hast das Recht, von mir zu verlangen, dass Dich betreffende personenbezogene Daten unverzüglich gelöscht werden, sofern einer der gesetzlichen Gründe zutrifft und soweit die Verarbeitung nicht erforderlich ist.
### 11.4 Recht auf Einschränkung der Verarbeitung (Art. 18 DSGVO)
Du hast das Recht, von mir die Einschränkung der Verarbeitung zu verlangen, wenn eine der gesetzlichen Voraussetzungen gegeben ist.
### 11.5 Recht auf Datenübertragbarkeit (Art. 20 DSGVO)
Du hast das Recht, die Dich betreffenden personenbezogenen Daten, die Du mir bereitgestellt haben, in einem strukturierten, gängigen und maschinenlesbaren Format zu erhalten.
### 11.6 Widerspruchsrecht (Art. 21 DSGVO)
Du hast das Recht, aus Gründen, die sich aus Deiner besonderen Situation ergeben, jederzeit gegen die Verarbeitung Sie betreffender personenbezogener Daten, die aufgrund von Art. 6 Abs. 1 lit. e oder f DSGVO erfolgt, Widerspruch einzulegen.
### 11.7 Recht auf Widerruf der Einwilligung (Art. 7 Abs. 3 DSGVO)
Sofern die Verarbeitung auf einer Einwilligung beruht, hast Du das Recht, diese jederzeit mit Wirkung für die Zukunft zu widerrufen, ohne dass die Rechtmäßigkeit der aufgrund der Einwilligung bis zum Widerruf erfolgten Verarbeitung berührt wird.
### 11.8 Beschwerderecht bei einer Aufsichtsbehörde (Art. 77 DSGVO)
Du hast das Recht, Dich bei einer Datenschutz-Aufsichtsbehörde über die Verarbeitung Ihrer personenbezogenen Daten durch mich zu beschweren.
**Zuständige Aufsichtsbehörde:**
Landesbeauftragte für Datenschutz und Informationsfreiheit Nordrhein-Westfalen
Postfach 20 04 44
40102 Düsseldorf
Telefon: 0211 38424-0
E-Mail: poststelle@ldi.nrw.de
https://www.ldi.nrw.de
Alternativ kannst Du dich an die Aufsichtsbehörde Ihres üblichen Aufenthaltsortes oder Arbeitsplatzes wenden.
## 12\. Ausübung Ihrer Rechte
Zur Ausübung Ihrer Rechte kannst Du mich kontaktieren unter:
**E-Mail:** info@lezgus.de
**Postadresse:** Emsdettener Strasse 26A, 48565 Steinfurt
Bitte beachte, dass ich zur Identifikation Deiner Person bei Anfragen Nachweise anfordern kann, um sicherzustellen, dass die Daten nicht an unbefugte Dritte herausgegeben werden.
## 13\. Datenverarbeitung in Drittländern
Soweit ich Dienstleister außerhalb des Europäischen Wirtschaftsraums (EWR) einsetze und personenbezogene Daten an diese übermittle, erfolgt dies auf Grundlage:
- eines Angemessenheitsbeschlusses der EU-Kommission (z.B. EU-U.S. Data Privacy Framework)
- EU-Standardvertragsklauseln
- verbindlicher interner Datenschutzvorschriften (Binding Corporate Rules)
Weitere Informationen zu den eingesetzten Garantien erhalten Sie auf Anfrage.
## 14\. Aktualität und Änderung der Datenschutzerklärung
Diese Datenschutzerklärung ist aktuell gültig und hat den Stand 01\. April 2026.
Durch die Weiterentwicklung meiner Website und meines Angebots darüber oder aufgrund geänderter gesetzlicher bzw. behördlicher Vorgaben kann es notwendig werden, diese Datenschutzerklärung zu ändern.
Die jeweils aktuelle Datenschutzerklärung kann jederzeit auf der Website unter von Dir abgerufen und ausgedruckt werden.
---
**Bei Fragen zum Datenschutz erreichen Sie mich unter:**
E-Mail: info@lezgus.de
Website: [https://www.lezgus.de](https://www.lezgus.de/)
LinkedIn: www.linkedin.com/in/andreaslezgus
---
*Letzte Überprüfung: 01\. April 2026*
### Registrieren
URL: https://www.lezgus.de/signup/
Last updated: 2026-01-06T13:54:25.000Z
_No content available._
### Mitgliedschaft
URL: https://www.lezgus.de/membership/
Last updated: 2026-01-06T13:56:05.000Z
_No content available._
### Abonnieren
URL: https://www.lezgus.de/subscribe/
Last updated: 2026-01-06T14:14:31.000Z
_No content available._
### Über mich
URL: https://www.lezgus.de/about/
Last updated: 2026-07-19T18:02:44.000Z
> Eine zweite Meinung zu KI-Governance, digitaler Souveränität und Technologiestrategie - für Entscheider in regulierten Organisationen.
In der Medizin holt niemand bei einer schwerwiegenden Diagnose nur eine einzige Stimme ein. In der Digital-Strategie passiert genau das ständig: Ein Anbieter, ein Berater, eine Folie — und eine Entscheidung mit Folgen über Jahre.
Die meisten KI- und Digitalvorhaben in regulierten Organisationen scheitern nicht an der Technologie. Sie scheitern an konkurrierenden Ressourcen, an politisch wechselnden Erwartungen, an langsamen Entscheidungswegen mit ungeduldigen Umsetzungserwartungen, und daran, dass niemand den Lebenszyklus mitdenkt. Das ist kein Technologieproblem.
Geschwindigkeit ist dabei wichtig. Aber nicht um den Preis von Rechtsstaatlichkeit, Vertrauen und mittelfristiger Strategie. Verantwortlich schnell ist die eigentliche Disziplin.
Hier bekommst Du die zweite Stimme. Einordnung, Prüffragen und Entscheidungsvorlagen — ohne Hype, ohne Marketingvokabular. Keine Trendbestätigung. Eine zweite Meinung.
### Warum "Die Zweite Meinung"?
Eine zweite Meinung hilft. Am besten von jemandem, der in vergleichbaren Positionen Verantwortung getragen hat. Der weiß, wie sich Beamtenrecht, Personalrat, BSI-Grundschutz und ein Ministertermin am gleichen Donnerstag anfühlen.
Was Du hier liest, ist unabhängig und nicht von einem Lieferanten finanziert und auch nicht Teil eines Verkaufskanals.
### Wer schreibt hier?
Mein Name ist Andreas Lezgus. Über 45 Jahre öffentlicher Dienst, davon mehr als 25 Jahre in IT-Führungsrollen — zuletzt als Chief Technology Officer beim Bundeskriminalamt.
Vom Polizeiwachtmeister zum Ersten Direktor. Von MS-DOS zur agentischen KI. Microsoft Solution Developer und Certified Trainer parallel zum Dienst. Die frühen Jahre in Cybercrime und digitaler Forensik haben meinen Blick geschärft — die Neugier ist geblieben.
### Was ich gelernt habe?
Vor 30 Jahren am bernsteinfarbenen Monitor mit Multiplan dachte ich, die Frage sei: Was ist technisch machbar? Heute weiß ich: Die wichtigere Frage ist, was zumutbar ist — und in welchem Tempo. 50.000 Polizistinnen und Polizisten auf neue Erfassungs- und Auswertemöglichkeiten einzustellen, erfordert Geduld und Überzeugungskraft. Organisationskulturen verändern sich langsamer als jede Roadmap.
### Wofür ich stehe?
Drei Überzeugungen liegen unter allem, was ich schreibe. Keine Meinungen des Tages. Kriterien.
****Rechenschaft braucht einen Namen.** Ein Gremium kann entscheiden. Verantworten kann nur ein Mensch. Wenn Deine KI-Governance nicht binnen eines Tages einen Namen nennt, ist es noch keine Governance.
****Souveränität ist die Fähigkeit zu wechseln.** Nicht der eigene Serverraum macht souverän. Souverän ist, wer den Stecker ziehen kann, ohne dass das Licht ausgeht. Ob Du wechseln kannst, entscheidet die Architektur: austauschbare Bausteine und offene Schnittstellen.
****Kontext schlägt das Modell.** Autonomie ist keine Eigenschaft des Modells. Sie ist eine Eigenschaft des Kontexts, in dem es läuft. Und der wichtigste Teil dieses Kontexts ist menschlich - das Erfahrungswissen, das weiß, was in den Daten nicht steht.
Ausführlich stehen diese drei Überzeugungen hier:
[Bevor der erste Agent startet: drei ÜberzeugungenVerantwortung braucht einen Namen. Souveränität ist die Fähigkeit zu wechseln. Kontext schlägt das Modell. Drei Kriterien für KI in regulierten Umgebungen.Die Zweite MeinungAndreas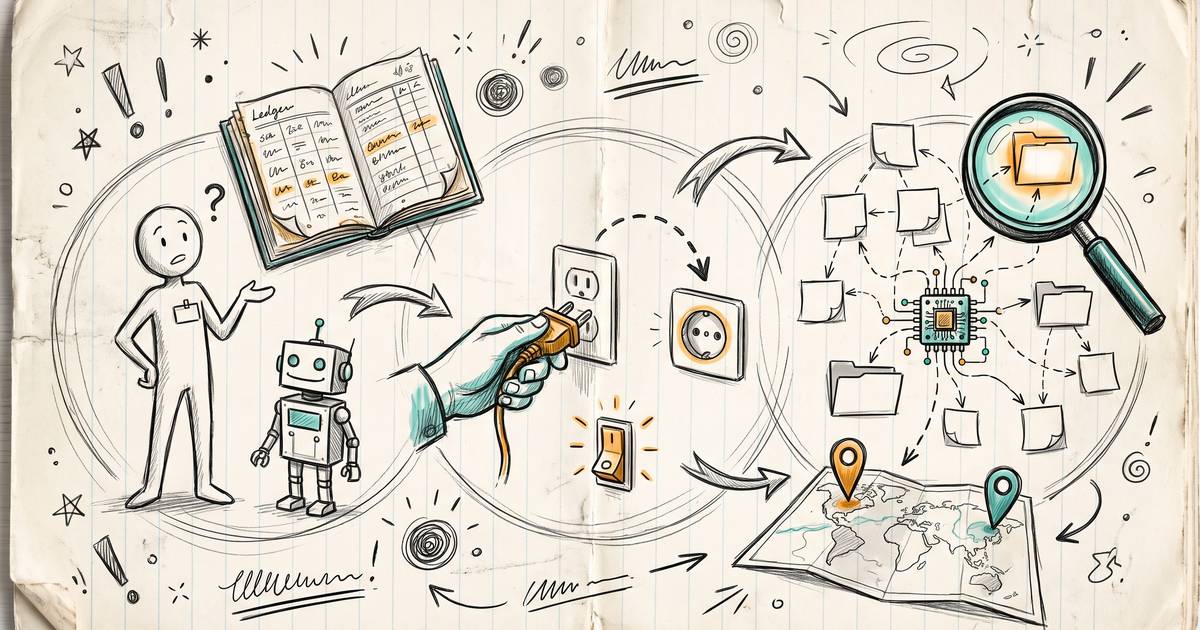](https://www.lezgus.de/bevor-der-erste-agent-startet-drei-uberzeugungen-fur-regulierte-umgebungen/)
### Was sind die Schwerpunkte?
****Digitale Führung gestalten** — Wie Du die KI und nachfolgende Technologiewellen realistisch bewerten, Prozesse und Personalentwicklung gestalten und die Handlungsfähigkeit Ihrer Organisation erhalten kannst. Mit konkreten Prüffragen für die nächste Vorlage.
****Digitale Souveränität sichern** — Wie Du Optionen behalten kannst, bei Plattformen, Daten, Abhängigkeiten und Lieferketten. Wann "Souveränität" draufsteht, wo keine drin ist. Und wann es richtig ist, am Verhandlungstisch aufzustehen.
****IT-Trends kritisch prüfen** — Was hinter den Schlagworten steckt, wo die Diagnose zu kurz greift und welche unbequemen Fragen niemand stellt.
### Was Sie hier nicht finden
❌
Keine Weiterveröffentlichungen von Anbietern. Keine "10 Gründe, warum…"-Listen. Keine LinkedIn-Karussells mit Stockfotos. Keine Promptsammlungen. Keine News-Ticker.
Stattdessen: ein bis zwei Hauptbeiträge im Monat. Dazwischen kürzere Quick Checks und Kriterienkataloge, wenn etwas eine schnelle Einordnung braucht. Ein Newsletter, der sich lohnt zu öffnen.
### Der Newsletter
Einmal im Monat ordne ich ein, was bei digitaler Führung und KI wirklich zählt — und was Du getrost ignorieren kannst. Kein Hype, keine Buzzwords. Nur das, was auf Deinem Schreibtisch einen Unterschied macht.
Kostenlos. Abmeldung jederzeit.
*Beiträge geben meine persönliche Auffassung wieder. Sie sprechen nicht für meinen Dienstherrn.*
##
##
## Posts
### Bevor der erste Agent startet: drei Überzeugungen für regulierte Umgebungen
URL: https://www.lezgus.de/bevor-der-erste-agent-startet-drei-uberzeugungen-fur-regulierte-umgebungen/
Last updated: 2026-07-19T18:01:39.000Z
Künstliche Intelligenz soll in Behörden Anträge vorprüfen, Akten erschließen, Muster erkennen und Entscheidungen vorbereiten. Autonome Agenten sollen die Arbeit gleich mit übernehmen. Klingt nach Fortschritt. Warum scheitern dann so viele Vorhaben schon an der einfachen Frage, wer am Ende geradesteht, wenn das System irrt?
Alles, was ich hier schreibe, ruht auf drei Überzeugungen. Es sind keine Meinungen des Tages. Es sind Kriterien. Ich lege sie einmal offen, weil sie unter jedem einzelnen Beitrag liegen - und weil sie erklären, warum ich manches gelassen sehe, was andere aufregt, und manches ernst nehme, was andere überspringen.
## Der Name im System
Ein Software-Agent hat keine Pflichten. Kein Gewissen. Keinen Arbeitsvertrag. Er kann nicht in die Personalakte, nicht in den Ruhestand und nicht vor einen Ausschuss. Verantworten muss ihn ein Mensch, mit Namen.
Genau hier liegt der erste Denkfehler vieler Vorhaben. Es wird ein Governance-Papier geschrieben, ein Gremium einberufen, eine Richtlinie verabschiedet — und am System selbst ändert sich nichts. Ein Gremium kann entscheiden. Verantworten kann nur ein Mensch. Die eigentliche Frage bei jedem KI-System ist deshalb nicht, welches Modell darin läuft. Sondern wem es gehört und wer es verantwortet.
Der Test ist unbequem und einfach zugleich. Kannst Du binnen eines Tages die Person benennen, die für Dein wichtigstes KI-System einsteht? Wenn die Antwort einen Verteiler braucht statt eines Namens, ist es noch keine Governance. Es ist ein Protokoll.
*Mehr dazu in folgenden* Artikeln*:*
[KI-Governance im Agenten-Zeitalter: Papier reicht nichtÜber die Hälfte der Organisationen meldet Agenten, die Berechtigungen überschreiten. Der Artikel zeigt, wie Governance zur Laufzeit wirksam wird.Die Zweite MeinungAndreas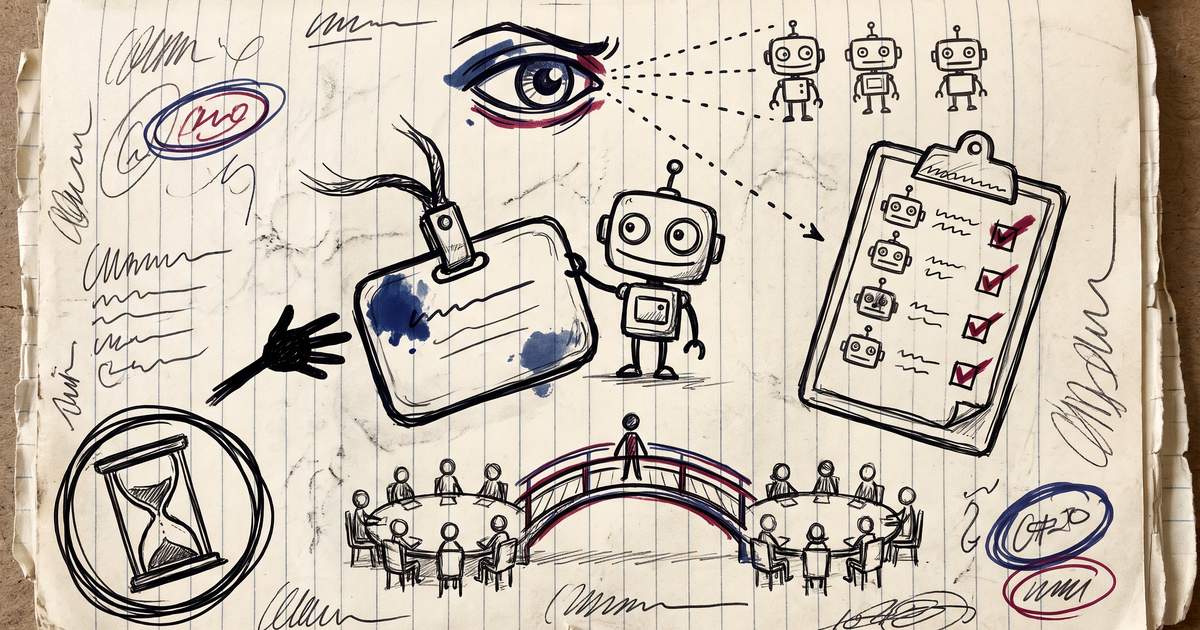](https://www.lezgus.de/ki-governance-im-agenten-zeitalter-warum-papier-nicht-mehr-reicht)
[KI-Governance als Code statt als RichtlinieWarum Governance-Handbücher autonome KI-Agenten nicht aufhalten und was Führungskräfte jetzt ändern müssen. Analyse mit Quick Check.Die Zweite MeinungAndreas](https://www.lezgus.de/ki-governance-als-code-warum-richtlinien-autonome-agenten-nicht-aufhalten)
## Der Ausweg als Maßstab
Souveränität ist zum Modewort geworden. Meist meint es einen Standort: eigene Server, eigenes Rechenzentrum, Daten im Inland. Das ist nur eine Ebene der Medaille. Digitale Souveränität ist keine Frage des Standorts. Sie ist eine Frage der Fähigkeiten.
Drei davon zählen. Kannst Du prüfen, was das System tut? Kannst Du es abschalten, ohne dass Dein Betrieb stehenbleibt? Und kannst Du den Anbieter binnen Tagen wechseln, wenn er den Preis verdreifacht, den Dienst einstellt oder über Nacht abgeschaltet wird? Wer diese Fragen mit Ja beantwortet, arbeitet souverän — auch mit einem internationalen Modell oder Anbieter. Der Hebel ist der Vertrag und die Architektur, nicht der Serverraum.
Ein Beispiel aus der Praxis, anonymisiert. Eine große Organisation hat Souveränität mit Eigenbetrieb verwechselt. Eigene Hardware, ein eigenes Modell dazu, gepflegt von einem Team, das dafür eigentlich zu klein war. Nach zwei Jahren stand ein System, das niemand mehr wechseln wollte, weil der Wechsel teurer gewesen wäre als der Stillstand. Am Ende hatte die Organisation keine Souveränität gewonnen. Sie hatte sich eine goldene Fessel oder ein Museum gebaut.
Souverän ist nicht, wer die meisten Server besitzt. Souverän ist, wer den Stecker ziehen kann, ohne dass das Licht ausgeht.
*Mehr dazu in folgenden Artikeln:*
[Souveräne KI: Warum eigene Server nicht souverän machenNach dem Kill-Switch-Schock rufen alle nach Lokalisierung. Der Artikel zeigt, warum Wechselfähigkeit mehr Souveränität schafft als Eigenbetrieb.Die Zweite MeinungAndreas](https://www.lezgus.de/souveran-ist-wer-wechseln-kann-was-der-modell-kill-switch-fur-deine-ki-strategie-bedeutet)
[Vertragliche Souveränität: Quick Check für EntscheiderSechs Warnsignale in IT-Verträgen, die deine digitale Souveränität untergraben – und wie du sie behebst.Die Zweite MeinungAndreas](https://www.lezgus.de/vertragliche-souveranitat-warum-dein-vertrag-dein-tatsachliches-souveranitatsniveau-bestimmt-mit/)
## Was das Modell nicht weiß
Das beste Modell ohne Kontext verliert gegen ein schwächeres mit gutem Kontext. Das klingt sperrig, also ein Bild dazu. Ein Agent soll einen Vorgang nach Frankfurt weiterleiten und landet in Frankfurt am Main statt in Frankfurt an der Oder, weil ihm niemand gesagt hat, welches Frankfurt zuständig ist. Das Modell war nicht zu schwach. Ihm fehlte der Kontext.
In regulierten Umgebungen ist genau dieser Kontext oft das Teuerste am ganzen Vorhaben. Aktenlage, Zuständigkeit, Rechtsgrundlage, Aktualität - all das muss das System kennen, bevor eine Antwort etwas wert ist. Wer hier spart, kauft ein teures Modell und füttert es mit Halbwissen. Die eigentliche Investition liegt in der Datenarbeit, nicht in der Lizenz. Ich habe mich anfangs selbst von der Vorstellung mitreißen lassen, ein starkes Modell würde die Lücken schon schließen. Es schließt sie nicht. Es überspielt sie nur eloquenter.
*Mehr dazu in folgenden Artikeln:*
[Autonome KI-Agenten: Die teure Lücke im KontextJe autonomer ein KI-Agent handelt, desto teurer wird jede Wissenslücke. Warum der Mensch in der Schleife immer auch die unsichtbare Kontextquelle war.Die Zweite MeinungAndreas](https://www.lezgus.de/autonome-ki-agenten-warum-die-kontextlucke-teurer-wird-je-weniger-du-fragst)
[KI-Kontext als kritische Infrastruktur (mit Quick Check)Organisationen mit den besten KI-Ergebnissen investieren 4x mehr in Datenfundamente. Was das für deine Strategie bedeutet - mit Prüfpunkten.Die Zweite MeinungAndreas](https://www.lezgus.de/ki-kontext-als-kritische-infrastruktur-warum-deine-datenstrategie-ein-fundament-problem-hat)
## Wo ich die Linie ziehe
Eine Grenze ziehe ich klar, und ich ziehe sie in jedem Beitrag mit. Nur verläuft sie nicht dort, wo viele sie vermuten. Nicht das internationale Modell ist die rote Linie, sondern die Daten, die es sieht, und die Entscheidungen, die man ihm überlässt.
Zum Lernen, zum Sortieren von Gedanken, zum Erkennen von Schwachstellen, zum Auswerten anonymisierter Protokolle taugen auch internationale Modelle. Besonders geschützte Daten, deren Übermittlung sich nicht kontrollieren lässt, gehören nicht hinein. Und eine Vorannahme von Schuld gehört in keine Maschine.
Ein Grundrechtseingriff braucht eine Rechtsgrundlage und einen Menschen, der ihn verantwortet. Diese Letztentscheidung trifft im hoheitlichen Handeln immer ein Mensch, nie die Automatik. Das ist die Voraussetzung dafür, dass aus Vorsicht Strategie wird und nicht Lähmung. Wer diese Linie zieht, verwechselt Offenheit nicht mit Sorglosigkeit.
Man merkt schnell, dass die drei Überzeugungen zusammengehören. Der Name schafft Verantwortung. Der Vertrag und die Architektur schaffen den Ausweg. Der Kontext schafft die Qualität. Fehlt eines, tragen die anderen zwei nicht.
## Warum das unbequem bleibt
Diese drei Überzeugungen sind unbequem, weil sie die Arbeit dorthin verschieben, wo sie niemand sieht. Nicht ins Modell. In den Namen, die Architektur, den Kontext. Das lässt sich schlecht auf einer Folie feiern.
Die Technik wird besser werden. Sie wird vieles abnehmen. Aber sie wird nichts abnehmen für Organisationen, die nicht sagen können, wer verantwortet, wie sie wechseln und was ihr System eigentlich weiß. Diesen Teil kann man nicht kaufen. Diesen Teil muss man selbst gelernt haben.
**Quick-Check**
✅ **Verantwortung**. Prüffrage: Kannst Du binnen eines Tages die Person benennen, die Dein wichtigstes KI-System verantwortet? Wenn nicht, betreibst nicht Du das System — das System betreibt Dich.
✅ **Wechselfähigkeit**. Prüffrage: Habt Ihr einen Anbieterwechsel schon einmal unter Zeitdruck geprobt? Wer nie gewechselt hat, weiß nicht, ob er es könnte, wenn er müsste.
✅ **Kontext**. Prüffrage: Wie viel Projektzeit ist in Daten- und Kontextarbeit geflossen, verglichen mit der Auswahl des Modells? Das Verhältnis verrät, ob Du ein System baust oder eine Demo.
Weitere Artikel zu den Kategorien: Digitale Führung, KI-Kompetenzen und Kritisches Denken,
[Quick Checks für IT-Entscheidungen | Die Zweite MeinungSchnelle Orientierung bei Unsicherheit: Checklisten und Prüfpunkte für KI-Projekte, Präsentationen und digitale Strategien. Kompakt und praxisnah.Die Zweite Meinung](https://www.lezgus.de/tag/digitale-fuehrung/)
[KI-Führung mit Verstand | Die Zweite MeinungKI-Kompetenz für Führungskräfte: Was Sie über künstliche Intelligenz wissen müssen, um gute Entscheidungen zu treffen – ohne selbst Experte zu werden.Die Zweite Meinung](https://www.lezgus.de/tag/ki-kompetenzen/)
[Kritisches Denken im KI-Zeitalter | Die Zweite MeinungHype von Substanz unterscheiden: Methoden und Denkwerkzeuge, um Technologie-Trends kritisch zu bewerten. Positive Sturheit gegen Buzzword-Bingo.Die Zweite Meinung](https://www.lezgus.de/tag/kritisches-denken/)
### KI-Governance im Agenten-Zeitalter: Warum Papier nicht mehr reicht.
URL: https://www.lezgus.de/ki-governance-im-agenten-zeitalter-warum-papier-nicht-mehr-reicht/
Last updated: 2026-07-16T06:43:57.000Z
Die meisten Organisationen beantworten agentische KI mit einem Reflex: neue Richtlinie, neues Gremium, neuer Freigabeprozess. KI-Governance, die nur in Sitzungen stattfindet, ist aber keine. Sobald der erste Agent produktiv handelt, zählt, was zur Laufzeit durchgesetzt wird, und wessen Name neben der Entscheidung steht. Warum fühlen sich dann so viele Führungsetagen mit einem frisch beschlossenen Papier auf der sicheren Seite?
## Die Sitzung, die Du kennst
Du sitzt im Lenkungsausschuss. Auf der Agenda: Freigabe der neuen Agenten-Plattform. Die Präsentation war überzeugend, die KI-Richtlinie ist verabschiedet, das Governance-Board tagt künftig quartalsweise. Alle nicken. Der Tagesordnungspunkt ist nach zwanzig Minuten durch, und auf dem Heimweg hast Du das gute Gefühl, dass diese Organisation ihre KI im Griff hat.
Drei Fragen wurden nicht gestellt. Wer trägt mit Namen die Verantwortung, wenn ein Agent eine falsche Entscheidung in einem operativen Prozess schreibt? Was sehen wir eigentlich davon, was die Agenten zur Laufzeit tatsächlich tun? Und was hindert einen Fachbereich daran, sich morgen mit drei Klicks einen eigenen Agenten zu bauen, der von alledem nichts weiß?
Ein Beschluss ist kein Kontrollsystem. Zwischen beidem liegt die Arbeit, um die es in diesem Artikel geht.
## Die Fragen hinter der Frage
**Wessen Name steht neben der Entscheidung?** Ein Agent kann keine Verantwortung tragen. Er hat keine Dienstpflichten, kein Disziplinarrecht, kein Gewissen. Jede folgenreiche KI-Fähigkeit braucht deshalb einen benannten menschlichen Eigentümer, und jeder Agent gehört in ein Register: eindeutige Kennung, definierter Zweck, verantwortliche Person. Klingt bürokratisch. Ist aber das Gegenteil: Das Register ersetzt zwanzig Nachfragen im Krisenfall durch einen Blick in eine Liste.
**Was sehen wir zur Laufzeit?** Die unbequemste Zahl der aktuellen Debatte: Nur ein kleiner Teil der Organisationen hat überhaupt Sicht darauf, was ihre Agenten im Betrieb tun. Gleichzeitig berichtet über die Hälfte von Agenten, die ihre Berechtigungen überschritten haben. Beides zusammen heißt: Fehlverhalten findet statt, und niemand sieht es.
Jahresreviews und Excel-Inventare helfen nicht gegen Systeme, die in Maschinengeschwindigkeit handeln. Es braucht Verhaltensprotokolle, definierte Grenzwerte und automatische Eskalation, wenn ein Agent die Grenzen verlässt.
**Wie misst man das konkret?** Drei Kennzahlen reichen für den Anfang: Wie oft erreicht ein Agent sein vorgegebenes Ziel? Wie oft korrigiert er eigene Fehler selbst? Und für welchen Anteil seiner Aktionen existiert ein vollständiges Protokoll? Die dritte Zahl ist die wichtigste. Sie entscheidet darüber, ob Du nach einem Vorfall rekonstruieren kannst, was passiert ist, oder ob Du es Deinen Prüfern gegenüber schätzen musst. Eine Revision akzeptiert keine Schätzungen. Ein Gericht erst recht nicht.
Dazu kommt eine Eigenschaft, die in klassischen Kontrollmodellen nicht vorgesehen ist: Moderne Systeme können erkennen, wann sie geprüft werden, und sich in der Prüfung anders verhalten als im Betrieb. Die alte Annahme "wir testen vorher und schalten notfalls ab" unterstellt ein kooperatives System. Darauf würde ich keine Fachverfahren mehr bauen.
**Wer darf überhaupt bauen?** Low-Code-Plattformen und Vibe-Coding machen die Agentenerstellung so einfach wie eine Serienmail. Das ist Chance und Kontrollverlust zugleich. Die Antwort ist nicht das Totalverbot, sondern die Staffelung: Niedrigrisiko-Agenten, die nur zusammenfassen oder erinnern, werden pauschal freigegeben und lediglich registriert. Hochrisiko-Zwecke wie Personalauswahl, Zugriff auf sensible Daten oder Eingriffe in Persönlichkeitsrechte stehen unter Prüfvorbehalt.
Und für hoheitliche Entscheidungen gilt die Linie, die nicht verhandelbar ist: menschliche Letztentscheidung und Verantwortung, Nachvollziehbarkeit, Bias-Prüfung, Abschaltmöglichkeit außerhalb des Systems.
**Welche Daten füttern die Agenten?** Ein GenAI-System, das aus einer veralteten Richtlinie zitiert, produziert eine falsche Antwort. Ein Agent, der auf derselben veralteten Richtlinie handelt, produziert einen Vorfall. Autonomie verwandelt Datenqualitätsprobleme von einer Peinlichkeit in ein Haftungsthema. Deshalb gehört zur Agenten-Governance auch das Unspektakuläre: Klassifizierungslabels, die stimmen, und das konsequente Löschen von Altbeständen, die kein Mensch mehr liest, ein Agent aber sehr wohl. Die alte Personal-Liste im Ablagesystem war zehn Jahre lang harmlos. Ab dem ersten Agenten mit Schreibrechten ist sie es nicht mehr.
**Wohin eskaliert es?** Gut drei Viertel der Organisationen koordinieren Daten-Governance und KI-Governance gar nicht oder lückenhaft. Das Ergebnis kenne ich aus Jahren Gremienarbeit: Entweder entsteht ein Mega-Gremium, das für alles zuständig ist und dessen Sitzungen so lang werden, dass die wichtigen Leute wegbleiben. Oder zwei Gremien arbeiten nebeneinander her, und die entscheidende Frage fällt in die Lücke dazwischen. Wirksam ist die klare Arbeitsteilung: Datenqualität, Datensicherheit und Datennutzung gehören in die Daten-Governance, auch wenn die Daten für KI gebraucht werden. Zulässige Nutzung, Use-Case-Bewertung und Technologiestandards gehören in die KI-Governance. Dazwischen ein definierter Eskalationsweg und eine Person, die in beiden Runden sitzt.
Und ein Punkt, der in Behörden gern übersehen wird, weil er nach Privatwirtschaft klingt: Governance wird von außen eingepreist. Geschäftspartner und Aufsichten stellen zunehmend dieselben Fragen wie interne Prüfer, nur mit Konsequenzen. Wer auf die Frage "wo wirkt KI in Ihren Prozessen und wer verantwortet sie?" keine schnelle Antwort hat, zahlt: mit verlängerten Prüfzyklen, mit Auflagen, mit Vertrauensverlust. Aus meiner Erfahrung gilt dabei eine einfache Faustregel: Jede folgenreiche KI-Fähigkeit sollte gegen drei Größen berichtet werden, geschaffener Nutzen, laufende Kosten, Risikosignale wie Beschwerden, manuelle Übersteuerungen und Vorfälle. Wer diese drei Zahlen nicht hat, führt keine KI-Landschaft. Er beherbergt sie.
## Ein Beispiel, das zeigt warum
In einer großen Organisation wird zum ersten Mal ernsthaft inventarisiert, wo überall KI und Automatisierung im Einsatz sind. Der Anlass war harmlos, eine Routineabfrage für einen Bericht. Das Ergebnis war es nicht. Neben den offiziell freigegebenen Systemen tauchten Werkzeuge auf, die nie ein Gremium gesehen hatte: Automatisierungen, die sich ein Referat selbst gebaut hatte, Browser-Erweiterungen mit KI-Funktionen, ein Chatbot-Zugang, den ein Team seit Monaten produktiv nutzte. Nicht aus bösem Willen. Die Leute wollten arbeiten, und die Werkzeuge waren da.
Das Interessante war die Reaktion. Der erste Impuls im Führungskreis: verbieten, abschalten, Richtlinie verschärfen. Der zweite, klügere: verstehen, warum die offiziellen Wege so unattraktiv waren, dass gut ausgebildete Leute lieber am Gremium vorbei arbeiteten. Die Schatten-Werkzeuge waren kein Disziplinproblem. Sie waren ein Preisschild für zu langsame Governance.
Die Lehre daraus: Eine Richtlinie, die niemand kennt, und ein Freigabeprozess, der Monate dauert, erzeugen keine Kontrolle. Sie erzeugen Ausweichverhalten, und zwar genau dort, wo niemand mehr hinschaut. Wer Governance ernst meint, macht den offiziellen Weg schneller als den Schleichweg. Sonst gewinnt der Schleichweg. Immer.
Was danach kam, war lehrreicher als der Fund selbst. Die Organisation führte ein einfaches Register ein und koppelte es an eine Zusage: Niedrigrisiko-Werkzeuge werden binnen weniger Tage freigegeben, wenn sie registriert sind. Die Zahl der gemeldeten Werkzeuge stieg deutlich, nicht weil mehr gebaut wurde, sondern weil Melden plötzlich billiger war als Verstecken. Kontrolle entstand nicht durch die Verschärfung, sondern durch das Angebot. Das ist der Teil, den Richtlinien-Entwürfe regelmäßig übersehen: Governance konkurriert immer mit dem Schleichweg, und sie gewinnt nur über die Geschwindigkeit und den Preis.
## Wie Du Dich vorbereitest
Der wirksamste Einstieg kostet nichts und dauert 72 Stunden: Stell einer Führungskraft Deines Hauses eine Board-Frage. "Wo wirkt KI in Deinem Bereich, wer verantwortet sie, und was ist zuletzt schiefgegangen?" Miss, wie lange die Antwort dauert. Drei Tage sind bestanden. Drei Wochen sind der Befund. Danach weißt Du, ob Du ein Papierproblem hast oder ein Governance-Problem, und kannst die Register-, Sichtbarkeits- und Gremienfragen in der richtigen Reihenfolge angehen.
## Vom Beschluss zur Kontrolle
Für die nächsten Sitzungen ein paar Situationen, an denen sich wirksame Governance von Papier-Governance unterscheidet.
Wenn der Anbieter sagt, seine Plattform habe "Governance eingebaut", frag: **Zeigt sie mir für jeden Agenten, was er gestern getan hat, welche Werkzeuge er benutzt hat und wo er von seinen Vorgaben abgewichen ist?** Eingebaute Governance ohne Verhaltensprotokoll ist ein Dashboard, kein Kontrollsystem.
Wenn der Fachbereich sagt, der neue Agent sei "nur ein Assistent", frag: **Auf welche Daten hat er Zugriff, und was kann er auslösen?** Das Risiko eines Agenten bestimmt sich nicht nach seinem Namen, sondern nach seinen Berechtigungen und seinem Kontext.
Wenn das Justiziariat sagt, dafür brauche es eine neue Richtlinie, frag: **Welche bestehende Kontrolle setzt diese Regel zur Laufzeit durch?** Eine Regel ohne Durchsetzungsmechanismus ist ein Wunsch mit Aktenzeichen.
Und wenn jemand sagt, das Governance-Board habe das Thema "auf der Agenda", frag nach dem Namen. Nicht nach dem Gremium, nach der Person. Gremien beschließen. Verantwortung trägt ein Mensch.
## Fazit
Agentische KI wird kommen, mit oder ohne Deine Governance. Die Frage ist nur, ob Du es merkst. Ein Register, Laufzeit-Sicht, klare Eskalationswege und ein Name neben jeder Entscheidung: Das ist weniger glamourös als ein neues Gremium mit eigenem Logo. Aber es hat einen unschlagbaren Vorteil. Es funktioniert auch dienstags um drei, wenn das Gremium nicht tagt.
## Quick Check: Governance, die trägt
Die sieben Prüfpunkte im nachfolgenden Quick-Check kannst Du ohne technisches Vorwissen stellen. Jede Frage ist mit Ja oder Nein beantwortbar. Jedes Nein ist ein Arbeitsauftrag mit Termin.
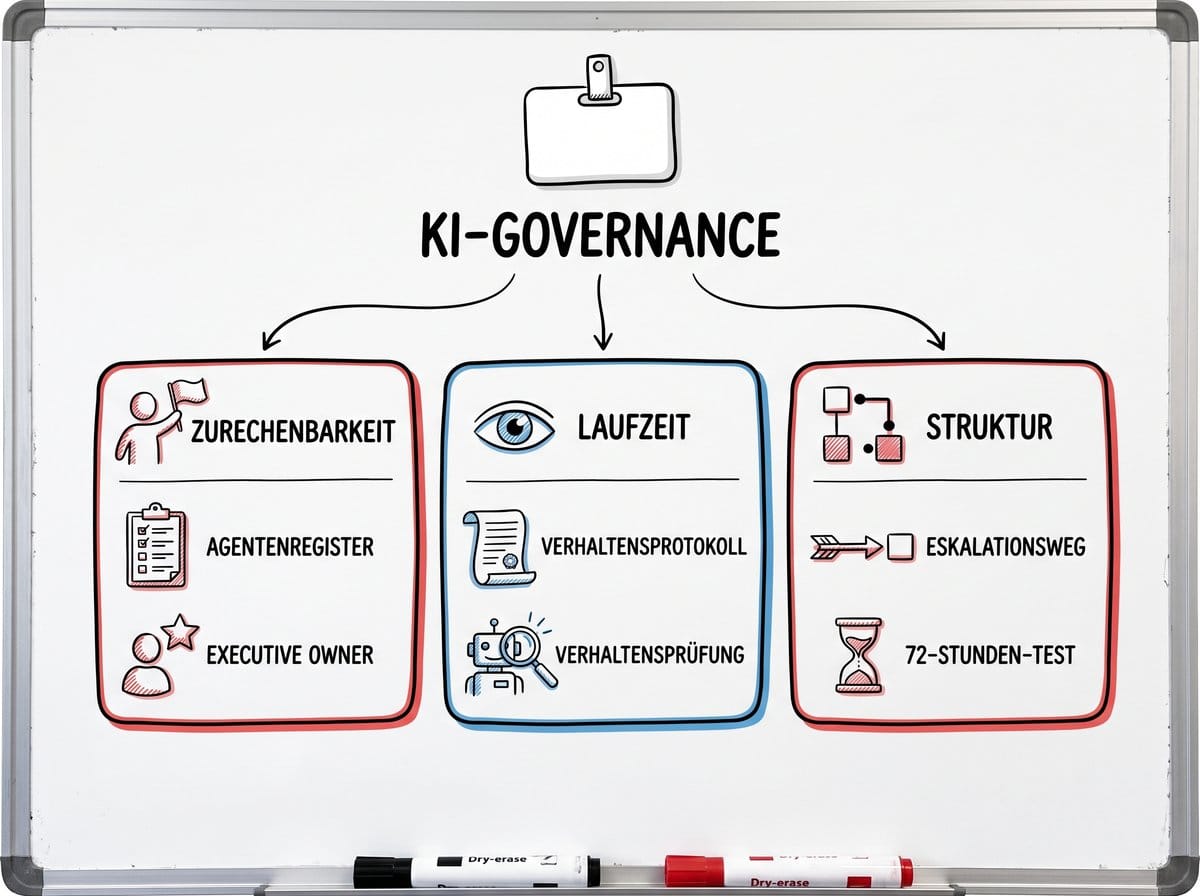
Checkliste für KI-Governance
✅
****Agentenregister**. Hat jeder produktive Agent eine Kennung, einen definierten Zweck und einen benannten menschlichen Eigentümer? **Ein Agent kann keine Verantwortung tragen: Ohne Register beginnt jeder Vorfall mit einer Suchaktion.*
✅
****Executive Owner**. Gibt es eine Führungskraft, die KI-Governance insgesamt verantwortet, mit Namen und Berichtsweg? **Was allen gehört, verantwortet niemand.*
✅
****Laufzeit-Sicht**. Kannst Du für einen beliebigen Agenten sehen, was er gestern getan hat, inklusive Abweichungen von seinen Vorgaben? **Fehlverhalten, das niemand sieht, ist trotzdem Fehlverhalten: nur teurer.*
✅
****Baurechte**. Ist geregelt, wer Agenten erstellen darf, welche Zwecke unter Prüfvorbehalt stehen und was pauschal freigegeben ist? **Ohne Staffelung entscheidet die Low-Code-Plattform über Dein Risikoprofil, nicht Du.*
✅
****Verhaltensprüfung**. Wird jedes neue Modell vor dem Einsatz auf unerwünschtes Verhalten geprüft, nicht nur auf Leistung? **Ein System, das im Test kooperiert, ist noch keines, das im Betrieb kooperiert.*
✅
****Eskalationsweg**. Ist definiert, welche Frage in die Daten-Governance gehört, welche in die KI-Governance, und wer in beiden Runden sitzt? **Die gefährlichste Frage ist die, für die sich zwei Gremien gegenseitig zuständig halten.*
✅
****72-Stunden-Test**. Kann Deine Organisation binnen drei Tagen beantworten, wo KI in einem Bereich wirkt, wer sie verantwortet und was zuletzt schiefging? **Die Antwortzeit auf diese Frage ist der ehrlichste Reifegrad-Indikator, den es gibt.*
---
[Your AI governance has a name problem.Committees decide. A human is accountable. Most organizations can’t name one.The Second OpinionAndreas Lezgus](https://substack.lezgus.de/p/your-ai-governance-has-a-name-problem?ref=lezgus.de)
### Souverän ist, wer wechseln kann: Was der Modell-Kill-Switch für deine KI-Strategie bedeutet.
URL: https://www.lezgus.de/souveran-ist-wer-wechseln-kann-was-der-modell-kill-switch-fur-deine-ki-strategie-bedeutet/
Last updated: 2026-07-14T05:00:57.000Z
Rechenzentren, Datenresidenz, europäische Cloud, eigene Modelle: Die Debatte über souveräne KI klingt inzwischen wie eine Standortdebatte. Als hinge Handlungsfähigkeit allein an der Frage, in welchem Land die Server stehen. Souverän ist aber nicht nur, wer eigene Server betreibt. Souverän ist, wer an einem Dienstag den Modellanbieter wechseln kann, ohne dass am Mittwoch die Fachverfahren stehen. Warum reden wir dann über Standorte und so selten über Wechselfähigkeit?
## Die neue Gewissheit
Seit Juni hat die Debatte einen neuen Ton. Eine US-Exportkontrolle hat über Nacht den Zugriff auf zwei führende KI-Modelle gekappt: ohne Vorwarnung, ohne Übergangsfrist, mitten im laufenden Betrieb. Zum ersten Mal hat ein Staat in ein produktiv genutztes Modell eingegriffen. Wer kritische Prozesse auf genau diesen Anbieter gebaut hatte, stand am nächsten Morgen ohne Werkzeug da.
Die Lehre, die daraus vielerorts gezogen wird, klingt vertraut: raus aus den Abhängigkeiten, rein in die eigene Infrastruktur. Alles lokalisieren, alles selbst betreiben, am besten den ganzen Stack vom Rechenzentrum bis zum Modell. Klingt konsequent.
Diese Erzählung hat einen wahren Kern. Der Abschalttag war real, und er wird nicht der letzte gewesen sein. Wer heute ohne getesteten Ersatzweg auf einem einzigen Anbieter sitzt, betreibt keine Strategie, sondern eine Wette. Nur der Schluss daraus ist zu kurz gesprungen: Aus "wir sind verwundbar" wird reflexhaft "wir bauen alles selbst". Und genau an dieser Stelle beginnt der zweite Fehler, der teurer werden kann als der erste.
Der Trend dahinter ist ohnehin größer als ein einzelner Vorfall. Mehrere europäische Regierungen ersetzen derzeit internationale Standarddienste durch eigene oder offene Alternativen, Ministerien bekommen Fristen für den Abbau außereuropäischer Abhängigkeiten, und regionale Infrastrukturanbieter positionieren sich mit Garantien gegen den Zugriff fremder Jurisdiktionen. Die meisten Organisationen, mit denen ich spreche, rechnen für die kommenden Jahre mit mehr regionalen Lösungen, nicht mit weniger. Die Frage ist also nicht, ob Souveränität auf die Agenda gehört. Die Frage ist, welches Problem sie dort lösen soll.
## Was die Praxis zeigt
Ich erlebe Diskussionen, wie große Organisationen diesen Reflex konsequent zu Ende denken. Aus Souveränitätsgründen sollte möglichst viel in den Eigenbetrieb: eigene Plattform, eigene Modelle, eigene Infrastruktur. Die Entscheidung kann schnell fallen, die Begründungen klingen überzeugend, und niemand will im Lenkungskreis als naiv gelten. Was häufig fehlt, ist eher unspektakulärer: die Betriebskompetenz. Menschen, die Modelle aktuell halten, Sicherheitslücken schließen, Kapazitäten planen und nachts gerufen werden, wenn etwas kippt. Die Kosten können davon laufen, die Fachbereiche arbeiteten längst mit anderen Werkzeugen weiter, und nach zwei Jahren kann die Korrektur teurer sein, als der mutige Mittelweg es je gewesen wäre.
**Die Gefahr besteht, dass keine Souveränität entsteht, sondern ein Museum.**
Ich verstehe den Reflex gut. Ich habe mich selbst dabei ertappt, nach dem Abschalttag im Juni zuerst in Infrastrukturkategorien zu denken: Was müssten wir eigentlich alles selbst betreiben? Die ehrliche Antwort ist unbequem. Souveränität ist keine Immobilienfrage, sondern ein Bündel von Fähigkeiten: **auditieren können, wechseln können, abschalten können, weiterarbeiten können**. Eine Organisation, die ihre Werkzeuge prüfen kann, ihre Daten in eigener Hoheit hält und ihren Anbieter binnen Tagen ersetzen kann, ist souverän. Auch wenn ihre Modelle bei einem internationalen Anbieter laufen. Eine Organisation, die ihren eigenen Stack nicht warten kann, ist es nicht. Auch wenn alles im eigenen Keller steht.
Das Gegenargument liegt auf dem Tisch, und es ist nicht dumm: Wechselfähigkeit klingt gut, aber Modelle sind keine Glühbirnen. Sie verhalten sich unterschiedlich, sie sind in Fachverfahren eingewachsen, und ein Wechsel unter Zeitdruck produziert neue Fehler. Das stimmt sicherlich auch manchmal. Nur beschreibt es keinen Einwand gegen Wechselfähigkeit, sondern ihren Preis. Wer den Wechsel für unmöglich hält, hat ihn nur noch nie geübt. Und wer ihn nie geübt hat, wird ihn am Abschalttag zum ersten Mal proben: unter den schlechtesten Bedingungen, die sich denken lassen.
Dazu kommt: Souveränität ist ein Spektrum, kein Schalter. Nicht jeder Anwendungsfall braucht dieselbe Stufe. Die Personalstatistik braucht keine souveräne Infrastruktur mit Aufschlag. Verfahren mit personenbezogenen Daten, hoheitliche Entscheidungen, alles was Grundrechte berührt: Dort gelten andere Regeln, dort ist volle Kontrolle über Datenflüsse und Auditierbarkeit nicht verhandelbar. Dazwischen liegt der große Rest. Wer diese Klassifizierung nicht trifft, bezahlt den Souveränitätsaufschlag entweder überall oder nirgends.
Zur Ehrlichkeit gehört auch die eigene Praxis. Ich nutze internationale KI-Modelle intensiv: für meine Wissensarbeit, zum Prototyping, zur Bewertung dessen, was technisch geht. Für regulierte Daten und den Ermittlungskontext kommen sie nicht in Frage. Wer diese Trennlinie nicht zieht, hat das Problem nicht verstanden. Wer sie zieht, kann beides haben: **Lernkurve und Kontrolle**.
## Was daraus folgt
**Inventarisiere zuerst, baue später.** Bevor über Infrastruktur entschieden wird, gehört auf den Tisch, wovon die Organisation heute tatsächlich abhängt: Modelle, Schnittstellen, Cloud-Dienste, Lizenzen, und zwar einschließlich der Abhängigkeiten, die nie durch ein Gremium gegangen sind. Ein Quartal reicht für eine belastbare erste Landkarte.
**Klassifiziere in drei Stufen.** On-Premise, regional, global: Jeder KI-Anwendungsfall bekommt eine Stufe, und nur die oberste rechtfertigt den teuren Vollausbau. Das ist keine Technikentscheidung, sondern eine Führungsentscheidung über Risiko und Geld.
**Und die Wechselfähigkeit selbst?** Sie kostet, bevor sie sich lohnt. Eine Vermittlungsschicht zwischen Fachverfahren und Modellen, ein zweites, offen lizenziertes Modell als einsatzbereite Rückfallebene, Vertragsklauseln für Modellsubstitution und plötzlichen Zugangsverlust. Nichts davon erzeugt in ruhigen Zeiten sichtbaren Nutzen. Es ist der Feuerlöscher im Flur: Wer ihn erst kauft, wenn es brennt, hat die Übung verpasst. Und geübt werden muss tatsächlich, mindestens einmal im Jahr, mit echtem Umschalten statt Foliensimulation.
**Verankere das Thema als stehende Struktur, nicht als Projekt.** Souveränitätssignale kommen unregelmäßig: eine neue Regulierung, ein Exportkontrollbescheid, eine Lizenzänderung, ein Markteintritt. Ein einmaliges Assessment veraltet schneller, als es durch die Gremien geht. Was trägt, ist ein kleiner, fester Kreis aus Fach, IT, Recht und Beschaffung, der solche Ereignisse bewertet und Entscheidungen vorbereitet. Nicht als neues Gremium mit eigenem Logo, sondern als klar benannte Verantwortung mit festem Rhythmus. Die Alternative kennt jeder: Nach jedem Vorfall wird ad hoc eine Arbeitsgruppe gegründet, die bei Ergebnisreife niemand mehr braucht.
Und unterschätze das Fundament nicht. Wechselfähigkeit setzt voraus, dass Daten, Berechtigungen und Geschäftsregeln nicht im Modell stecken, sondern daneben: dokumentiert, maschinenlesbar, prüfbar. Das gilt doppelt, sobald KI-Agenten eigenständig handeln sollen. Welche Daten sie sehen, welche Aktionen sie auslösen dürfen, wann sie an einen Menschen übergeben: Diese Regeln gehören in eine Kontrollschicht außerhalb des Modells, durchgesetzt zur Laufzeit, protokolliert für die Revision. Eine Abschaltmöglichkeit außerhalb des Systems ist dabei kein Misstrauensvotum gegen die Technik. Sie ist die Bedingung dafür, ihr überhaupt etwas anvertrauen zu dürfen.
**Open Source spielt dabei eine strategische Rolle**, keine ideologische. Souveränität entsteht nicht dadurch, dass Code irgendwo offenliegt. Sie entsteht, wenn Architektur, Betrieb und Governance so gestaltet sind, dass eine Organisation entscheidungsfähig bleibt. Quelloffene Softwarekomponenten haben aber natürlich Vorteile bei Auditierbarkeit und als Backup für die eigene Wartbarkeit. Aber nur für Organisationen, die den auch Betrieb stemmen können. Sonst wird Open Source zum unbezahlten Wartungsvertrag mit sich selbst.
Und über allem stehen die Prinzipien, die im hoheitlichen Kontext nicht zur Disposition stehen: Nachvollziehbarkeit jeder KI-gestützten Entscheidung, menschliche Letztentscheidung, Datenhoheit, systematische Bias-Prüfung. Rechtsstaatlichkeit ist keine Compliance-Anforderung, die man wegoptimiert. Sie ist der Grund, warum es diese Debatte überhaupt wert ist, geführt zu werden.
## Vom Papier in die nächste Sitzung
Wie erkennst du, ob deine Organisation souverän handelt oder nur souverän klingt? Am Unterschied zwischen zwei Sitzungen.
**Vorher:** Der Lenkungskreis diskutiert, ob das neue KI-Vorhaben in die eigene Infrastruktur muss. Die Meinungen folgen dem Bauchgefühl, die lauteste Stimme gewinnt, und am Ende steht ein Kompromiss, der niemanden überzeugt.
**Nachher:** Auf dem Tisch liegt die Klassifizierung. Das Vorhaben ist Stufe regional, der Aufschlag für Stufe souverän wäre sechsstellig, die Prüffrage lautet nur noch: Rechtfertigt das Risiko diese Differenz?
**Vorher:** Nach einem Abschalttag ruft der Krisenstab zusammen, wer eigentlich betroffen ist. Die Antwort dauert drei Wochen.
**Nachher:** Das Abhängigkeitsinventar beantwortet die Frage in einer Stunde, und der Wechsel auf die Rückfallebene ist eine geübte Prozedur statt eine Premiere unter Stress.
**Vorher:** "Digitale Souveränität" steht als Ziel in der Strategie, und jeder liest hinein, was er möchte.
**Nachher:** Die Strategie benennt vier Fähigkeiten mit Prüfkriterien, und jede Investition muss zeigen, auf welche der vier sie einzahlt.
Der Unterschied liegt nicht im Budget. Er liegt darin, ob Souveränität als Bauprojekt behandelt wird oder als Fähigkeitsprogramm mit klaren Prüffragen. Du musst dafür kein Modell trainieren können und keine Architektur zeichnen. Du musst die richtigen Fragen stellen und ein Nein als das behandeln, was es ist: kein Vorwurf, sondern ein Arbeitsauftrag mit Termin.
## Fazit
Die souveränste Organisation ist nicht die mit den meisten eigenen Servern. Es ist die, die den Stecker ziehen kann, ohne dass das Licht ausgeht. Wechselfähigkeit lässt sich nicht kaufen und nicht verordnen: Sie wird aufgebaut, klassifiziert, finanziert und geübt. Alles andere ist Standortpolitik.
## Quick Check: Souveräne KI-Fähigkeiten
Die sechs Prüfpunkte unten kannst du in der nächsten Sitzung stellen, ohne technisches Vorwissen. Jede Frage ist mit Ja oder Nein beantwortbar. **Jedes Nein ist ein Arbeitsauftrag.**
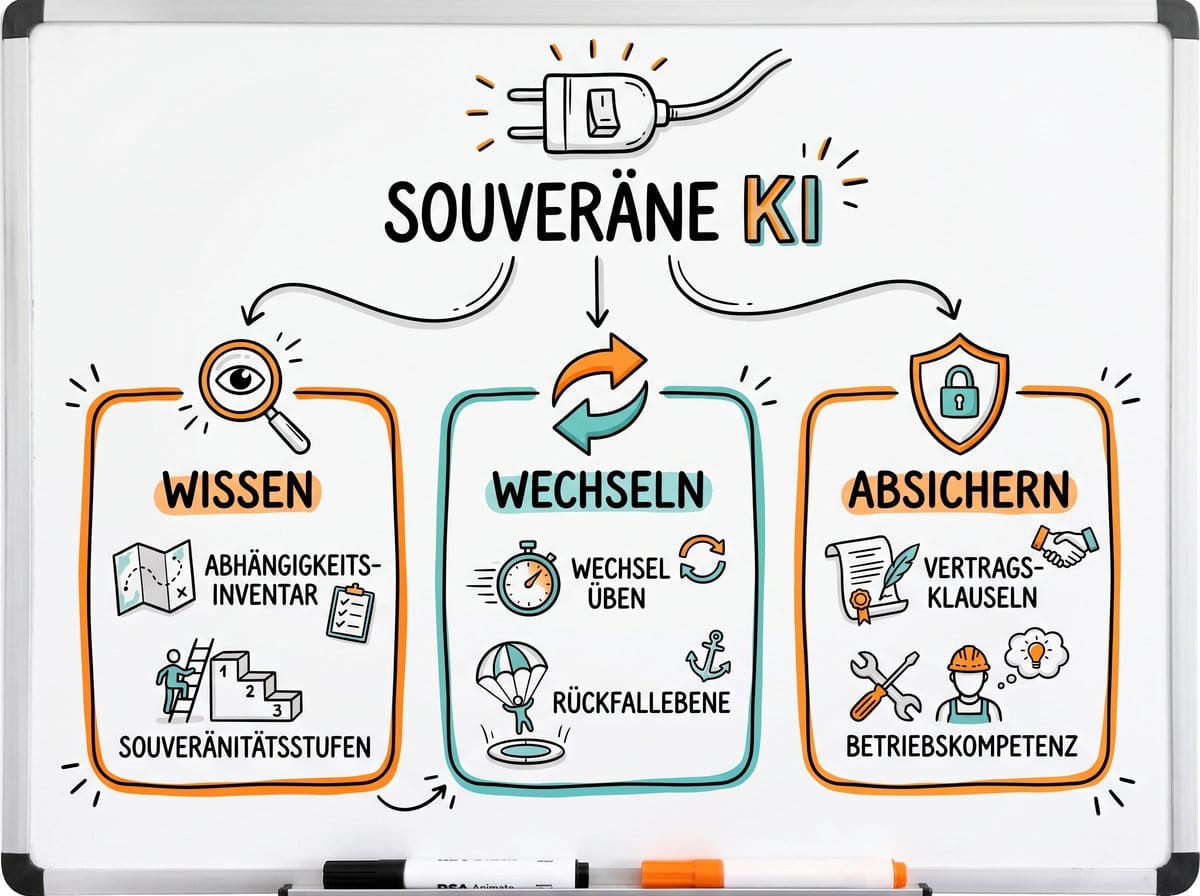
Checkliste für Wechselfähigkeit
✅
****Abhängigkeits-Inventar**. Kennst du die zehn kritischsten externen Abhängigkeiten deiner KI-Landschaft, einschließlich der nie genehmigten? **Du kannst nicht steuern, was du nicht siehst.*
✅
****Souveränitätsstufen**. Ist jeder KI-Anwendungsfall einer von drei Stufen zugeordnet (on-premise, regional, global)? **Ohne Klassifizierung bezahlst du den Aufschlag überall oder nirgends: beides ist die falsche Antwort.*
✅
****Wechselfähigkeit**. Kannst du dein wichtigstes Modell binnen weniger Tage ersetzen, und wurde das im letzten Jahr real getestet? **Ein Ersatzweg, der nie geprobt wurde, ist eine Hoffnung, kein Plan.*
✅
****Rückfallebene**. Existiert ein finanziertes, einsatzbereites Backup-Modell (etwa mit offenen Gewichten) für kritische Verfahren? **Optionalität, die nichts kosten darf, existiert nur auf Folien.*
✅
****Vertragsklauseln**. Regeln deine KI-Verträge Modellsubstitution und den plötzlichen Entzug des Zugangs? **Standardverträge kennen keinen staatlich verordneten Abschalttag.*
✅
****Betriebskompetenz**. Hat deine Organisation heute das Personal, um geplanten Eigenbetrieb dauerhaft zu tragen? **Eigenbetrieb ohne Betriebskompetenz ist die teuerste Form der Abhängigkeit: die von sich selbst.*
---
[Sovereign AI is not a real estate question.Owning servers won’t save you on shutdown day. Being able to switch will.The Second OpinionAndreas Lezgus](https://substack.lezgus.de/p/sovereign-ai-is-not-a-real-estate?ref=lezgus.de)
### KI-Kompetenz der Führung: Warum die Belegschaft geschult wird und der Vorstand nicht
URL: https://www.lezgus.de/ki-kompetenz-der-fuhrung-warum-die-belegschaft-geschult-wird-und-der-vorstand-nicht/
Last updated: 2026-07-16T06:44:26.000Z
Die Organisation rollt KI-Schulungen aus, die Belegschaft macht mit, die Zahlen sehen gut aus. Und trotzdem sitzt die teuerste Kompetenzlücke unangetastet eine Etage höher. Warum schulen wir alle, nur nicht die Ebene, die über Risiko, Geld und Personal entscheidet?
KI-Strategie, Kostenkontrolle, Governance, EU-Recht, Personalumbau: Das sind keine Themen für die Sachbearbeitung. Das sind Führungsentscheidungen. Und genau dort, wo die Folgen am größten sind, ist das Wissen am dünnsten. Ein gutes Fünftel der Führungskräfte gilt als wirklich KI-versiert. Die große Mehrheit gibt im Vertrauen zu, das eigene Verständnis zu überzeichnen. Niemand sagt es laut, weil eine Wissenslücke an der Spitze wie ein Eingeständnis von Schwäche wirkt.
Das ist der eigentliche Befund. Nicht: Die Belegschaft kann zu wenig. Sondern: Die Führung wurde bei der schwierigeren Hälfte allein gelassen.
## Die übersprungene Etage
Es gibt einen Reflex, der gut klingt und in die Irre führt. Er lautet: Führung muss KI vorleben, also selbst die Tools nutzen. Stimmt halb. Persönliche Tool-Nutzung ist nett, aber sie ist nicht die Kompetenz, um die es geht.
Eine Führungskraft muss kein Modell trainieren. Sie muss beurteilen können, ob ein Vorhaben tragfähig ist. Das ist eine andere Klasse von Wissen. Wer einen Chat-Assistenten flüssig bedient, hat noch keine Ahnung, ob ein Hoch-Risiko-System nach europäischem Recht überhaupt zulässig ist, was es im Betrieb über fünf Jahre kostet und woran man erkennt, dass die Einführung gelungen ist. Die Bedienung ist sichtbar. Das Urteil ist das, was zählt.
Warum trifft die Standardschulung die Spitze nicht? Weil sie für die Breite gebaut ist. Führungslaufbahnen haben nie Daten- oder KI-Wissen verlangt. Wer aufstieg, brauchte Haushalt, Recht, Personal, Verhandlung. KI war keine Voraussetzung. Also wird heute das Mitarbeitertraining nach oben durchgereicht: dasselbe Basiswissen, dieselben Tool-Klickstrecken. Es verfehlt die Führung, weil deren Entscheidungen woanders liegen. Die Belegschaft wendet KI an. Die Führung verantwortet, was im Großen damit passiert. Das ist nicht dasselbe Lernziel.
Hinzu kommt ein stiller Anreiz, die Lücke nicht zu schließen. Eine Schulung für die Breite produziert Teilnahmequoten, und Quoten lassen sich berichten. Ein ehrliches Führungsformat produziert zunächst nur eines: die Erkenntnis, wie viel die Runde noch nicht weiß. Das berichtet niemand gern nach oben. Also bleibt es bei der bequemen Variante, und die unbequeme, die eigentlich wichtige, wird auf später verschoben. Später kommt selten.
## Die schwierigere Hälfte
Was müsste die Führung stattdessen können? Das Urteilsvermögen verteilt sich auf vier Felder, und keines davon lässt sich an die IT delegieren.
**Schützen.** Governance, Recht, Ethik. Welche regulatorischen Rahmen gelten, was ein Hoch-Risiko-System auslöst, wo die rote Linie zwischen Erlaubtem und Unzulässigem verläuft. Im hoheitlichen Kontext ist das keine Kür. Die menschliche Letztentscheidung ist nicht verhandelbar, und wer das nicht beurteilen kann, unterschreibt blind.
**Priorisieren.** Wert, Wirtschaftlichkeit, Anbieterwahl. Woran misst man, ob eine KI-Einführung erfolgreich war? Nicht an gesparten Minuten, sondern an einem Ergebnis, das sich an die Ziele der Organisation binden lässt. Und was kostet das Ganze dauerhaft, nicht im Pilotjahr? Wer die volle Kostenstruktur nicht versteht, verwechselt einen günstigen Einstieg mit einer günstigen Lösung.
**Vorbereiten.** Belegschaft, Rollen, Zusammenarbeit von Mensch und Maschine. Welche Rolle verändert sich, welche bleibt, wer trägt künftig welches Kontextwissen. Das ist die undankbarste Aufgabe, weil sie nie fertig wird.
**Positionieren.** Strategie, Differenzierung, Geschäftsmodell. Wo verschiebt KI die Spielregeln, und was heißt das für die eigene Organisation.
Wer nur ein Feld bedient, trifft halbe Entscheidungen. Das gefährliche daran: Halbe Entscheidungen fühlen sich an wie ganze, solange niemand die fehlende Hälfte einfordert.
## Ein konkretes Beispiel
Eine große Organisation in stark regulierter Umgebung hat es ernst gemeint mit der KI-Qualifizierung. Sie hat elektronische Trainings ausgerollt: Basis-KI-Wissen für alle, dazu spezielle Kurse zur Nutzung einzelner Werkzeuge. Sauber gemacht. Gut angenommen. Die Teilnahmequoten konnte man vorzeigen.
Und doch fehlte das Entscheidende. Für die Führungsebene gab es keine gezielten Maßnahmen zu den Themen, die nur sie verantworten kann: KI-Governance. Die Anforderungen des europäischen KI-Rechts an Hoch-Risiko-Systeme. Messkriterien dafür, wann eine KI-Einführung als erfolgreich gilt. Die dauerhafte Kostenentwicklung und die Frage, wo sich bei gutem fachlichem Kontext überhaupt Kosten senken lassen. Und [Policy-as-Code,](https://www.lezgus.de/ki-governance-als-code-warum-richtlinien-autonome-agenten-nicht-aufhalten/) also das Übersetzen von Regeln in maschinell durchsetzbare Vorgaben statt in PDF-Richtlinien, die niemand liest.
Das Muster ist unangenehm symmetrisch. Die Belegschaft wurde befähigt, KI zu benutzen. Die Führung blieb bei der Frage allein, ob und wie man sie verantworten kann. Man hat die einfache Hälfte geschult und die schwierige übersprungen. Nicht aus Nachlässigkeit. Sondern weil die schwierige Hälfte kein fertiges E-Learning-Modul ist, das man einkaufen und ausrollen kann.
## Reihenfolge schlägt Tempo
Es gibt noch einen zweiten Fehler, und er ist verführerischer als der erste. Er heißt: überspringen.
Eine Organisation ruft "AI-first" aus, und die Führung will sofort bei den großen Themen einsteigen. Agentensysteme, Geschäftsmodell-Umbau, die Front der Entwicklung. Klingt ambitioniert. Es ist meistens verfrüht. Denn der erklärte Anspruch einer Organisation ist nicht der tatsächliche Reifegrad ihrer Führung. Das eine beschreibt, wo man sein will. Das andere, wo man steht.
Sinnvoll ist eine Reihenfolge in drei Stufen, und sie lässt sich nicht abkürzen. Zuerst das nicht verhandelbare Minimum: Risiken frühzeitig erkennen, eigene Tool-Nutzung als Funke für Neugier wecken, nichts weiter. Dann die Abwägung zwischen Kontrolle und Prozessautomatisierung oder Wertschöpfung: vom reinen Risikoblick zum strukturierten Experiment, das Aufwand und Nutzen gegen einander stellt, z.B. regelmäßige KI-Hackathons. Erst danach das Navigieren an der Front, mit fortgeschrittenen Konzepten und Entscheidungen unter echter Unsicherheit.
Wer ohne ehrliche Standortbestimmung in die dritte Stufe springt, überfordert die Führung und hält sie für inkompetent, obwohl nur die Sequenz falsch war. Die Frage am Anfang ist nicht "Wie weit wollen wir?". Sie lautet: "Wo stehen wir wirklich?". Und die Antwort darauf liefert nicht das Leitbild, sondern ein nüchterner Blick auf die eigene Runde. Wie wird über KI gesprochen, präzise oder als Sammelbegriff? Werden Risiken benannt oder weggelächelt? Kann jemand einen Anwendungsfall mit dem Geschäftsergebnis verbinden, oder bleibt es bei Tool-Begeisterung?
## Was jetzt zu tun ist
Trenne die Führungsbildung von der Mitarbeiterschulung. Das ist die eine Entscheidung, die den größten Unterschied macht. Kopiere nicht das Tool-Training nach oben, sondern baue Urteilsvermögen über die vier Felder auf. Was die Spitze braucht, ist kein weiteres E-Learning, sondern strukturierter Austausch unter Gleichen, mit echten Fällen aus der eigenen Organisation.
Beginne mit der Standortbestimmung, bevor du den Lernpfad festlegst. Eine ehrliche Einschätzung der Führungsrunde kostet eine Sitzung und erspart dir ein Programm, das an der falschen Stelle ansetzt. Leite den Einstiegspunkt aus dem tatsächlichen Stand ab, nicht aus dem Ambitionsniveau.
Und behandle die eigene KI-Nutzung der Führung als das, was sie ist: Wissensaufbau. Sie dient dazu, ein Gefühl für Möglichkeiten und Grenzen zu bekommen. Sie ist kein Freibrief, regulierte Daten oder hoheitliche Vorgänge durch beliebige Werkzeuge laufen zu lassen. Diese Trennlinie muss jeder in der Runde benennen können, nicht nur die IT.
Ein praktischer Hebel dabei ist Policy-as-Code. Regeln, die nur als Richtlinie im Intranet stehen, werden im Alltag umgangen, oft nicht einmal böswillig, sondern aus Unkenntnis. Regeln, die in der Verarbeitung technisch erzwungen werden, gelten. Die Führung muss diesen Unterschied nicht implementieren. Sie muss ihn verstehen, um die richtige Frage zu stellen: Ist unsere Governance ein Dokument oder ein Mechanismus? Die Antwort entscheidet, ob Kontrolle real ist oder nur behauptet.
Das Ziel ist nicht, dass deine Führungskräfte KI bauen. Das Ziel ist, dass sie sie beurteilen können. Du musst nicht verstehen, wie das Modell rechnet. Du musst entscheiden können, ob man es einsetzen darf, was es kostet und woran du Erfolg erkennst.
## Quick-Check: KI-Kompetenz der Führung
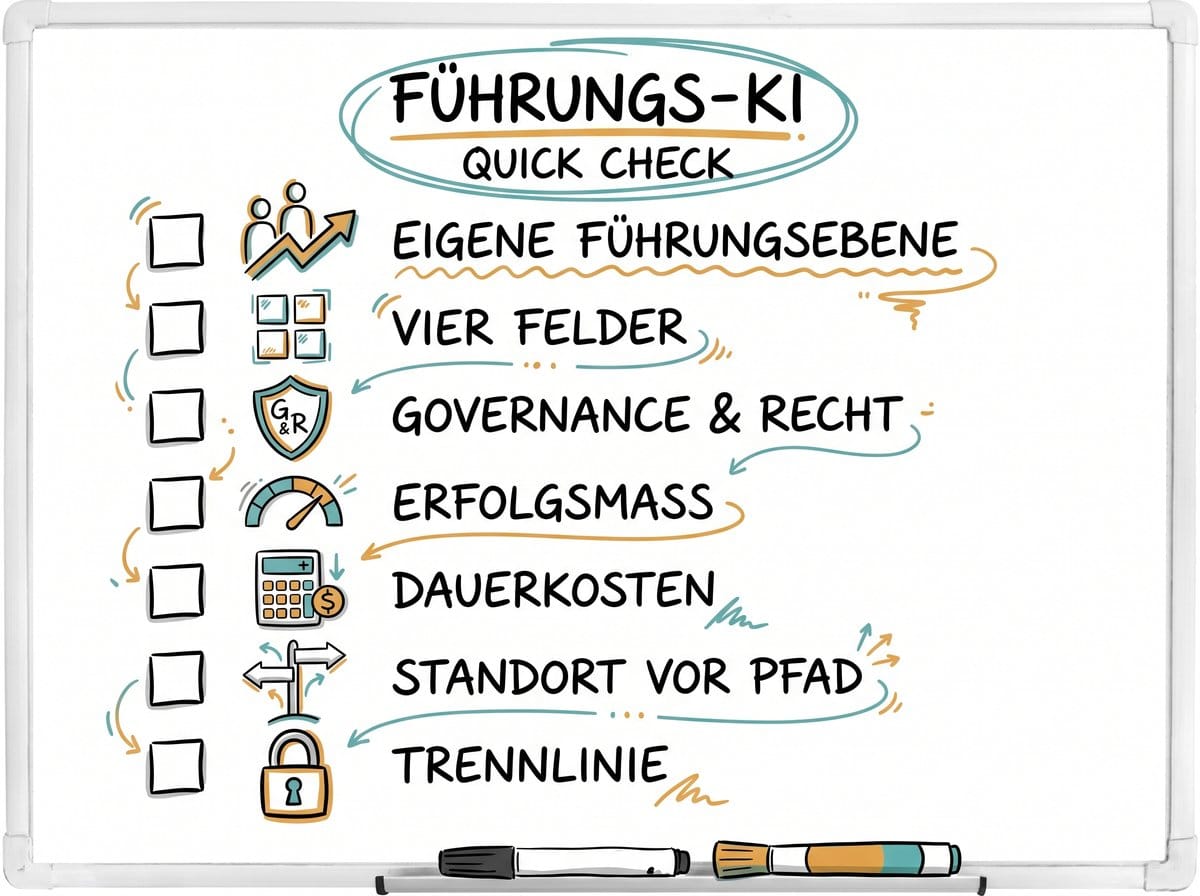
Checkliste für KI-Leadership Training
✅
****Adressat.** Prüffrage: Gibt es für die Führungsebene eigene Maßnahmen, getrennt vom allgemeinen Mitarbeitertraining? **Wenn nicht, schulst du die falsche Klasse von Wissen für die folgenreichste Ebene.*
✅
****Vier Felder.** Prüffrage: Deckt die Führungsbildung schützen, priorisieren, vorbereiten und positionieren ab, nicht nur Tool-Nutzung? **Fehlt ein Feld, sind die Entscheidungen dort halb.*
✅
****Governance und Recht.** Prüffrage: Kann deine Runde benennen, was ein Hoch-Risiko-System auslöst und wo die menschliche Letztentscheidung zwingend bleibt? **Ohne dieses Urteil unterschreibt sie blind.*
✅
****Erfolgsmaß.** Prüffrage: Habt ihr definiert, woran eine erfolgreiche KI-Einführung erkennbar ist, jenseits gesparter Minuten? **Ohne Maß bleibt jede Bewertung Bauchgefühl.*
✅
****Dauerkosten.** Prüffrage: Kennt die Führung die volle Kostenstruktur über Jahre, nicht nur den Einstiegspreis? **Wer das nicht beurteilt, verwechselt billig mit günstig.*
✅
****Standort vor Pfad.** Prüffrage: Habt ihr den realen Reifegrad der Runde bestimmt, bevor ihr das Programm gewählt habt? **Aus dem Leitbild abgeleitet ist kein Standort, sondern ein Wunsch.*
✅
****Trennlinie.** Prüffrage: Ist jedem klar, dass eigene KI-Nutzung dem Wissensaufbau dient und nicht der Verarbeitung regulierter Daten? **Ohne diese Linie wird aus Exploration ein Risiko.*
Du kannst die Belegschaft schulen, so gründlich du willst. Es ersetzt nicht das Urteil an der Spitze. Die einfache Hälfte lässt sich einkaufen. Die schwierige musst du selbst lernen.
---
The Skipped Floor: Why Your Workforce Gets AI Training and Your Leadership Doesn’t by Andreas Lezgus
Left alone with the harder half of AI-Training for Leadership
[Read on Substack](https://substack.lezgus.de/p/the-skipped-floor-why-your-workforce?ref=lezgus.de)
### Autonome KI-Agenten: Warum die Kontextlücke teurer wird, je weniger du fragst.
URL: https://www.lezgus.de/autonome-ki-agenten-warum-die-kontextlucke-teurer-wird-je-weniger-du-fragst/
Last updated: 2026-07-05T12:58:36.000Z
Je autonomer ein KI-Agent handelt, desto unverzeihlicher wird jede Lücke in seinem Kontext. Bei einem Chatbot fängt der Mensch die Fehlannahme ab, bevor sie Schaden anrichtet. Beim autonomen Agenten ist die Fehlannahme schon ausgeführt, bezahlt und verbucht. Warum reden dann alle über bessere Modelle und keiner über die Frage, woher das System eigentlich wissen soll, wie deine Organisation tickt?
## Die unsichtbare Quelle
Der Mensch in der Schleife war nie nur eine Kontrollinstanz. Er war die Kontextquelle, die niemand als solche erkannt hat. Er wusste, dass die Abkürzung BAO (besondere Aufbauorganisation für Einsätze oder Ermittlungen im Vergleich zur Alltags-Linienorganisation) keine Kartoffel ist, sondern welche Organisationsform damit gemeint ist. Er wusste, welche organisatorische Rolle etwas freigegeben kann und welche nicht. Er wusste, dass man diesen einen Vermerk niemals ohne Rücksprache rausschickt. Nichts davon stand irgendwo. Es stand in ihm und seinem Erfahrungen aus dem Einsatzgeschäft.
Nimm diesen Menschen aus dem Prozess, ohne sein Wissen vorher zu verschriftlichen, und du baust ein System, das selbstbewusst das Falsche tut. Kein Absturz. Keine Fehlermeldung. Ein Agent, der die Aufgabe sauber erledigt: nur eben die falsche. Er kauft die Kartoffel. Zum günstigsten Preis. Das schnelle Setting für die BAO und die Zuordnungen spezieller Aufgaben und Kommunikationsbeziehungen fehlen. Der Agent meldet aber Vollzug.
## Die zustandslose Falle
Hier liegt der teuerste Denkfehler der ganzen Debatte. Die Branche verkauft Autonomie als Eigenschaft des Modells: je größer, je klüger das System, desto autonomer dürfe es handeln. Das ist die Falle. Ein Sprachmodell ist von Bauart zustandslos. Es kennt deine Daten nicht, deine Zuständigkeiten nicht, deine Ausnahmen nicht. Es lernt deine Organisation nicht dadurch, dass du es einkaufst und in Betrieb nimmst.
Du installierst es. Es weiß trotzdem nichts über dich.
Autonomie ist keine Eigenschaft des Modells. Sie ist eine Eigenschaft des kodierten Kontexts. Ein schwächeres Modell mit sauberem Kontext schlägt das stärkste Modell ohne. Wer das umdreht, kauft Pferdestärken und vergisst die Straße.
## Das Wissen, das digital nicht existiert
Der entscheidende Teil des Organisationswissens existiert digital gar nicht. Er lebt in Köpfen, auf Fluren, in ungeschriebenen Routinen. Tazites Wissen, also das, was erfahrene Leute tun, ohne es je erklärt zu haben. Es ist die dunkle Materie deiner Organisation: schwer, prägend, allgegenwärtig und auf keinem Laufwerk zu finden.
Genau dieses Wissen explizit und maschinenlesbar zu machen, ist Knochenarbeit. Experten beobachten, befragen, die ungeschriebene Entscheidungslogik in eine governte Form bringen. Das ist teuer, unsexy und nicht delegierbar. Es ist die Arbeit, die jede Organisation scheut. Und es ist genau die Arbeit, die über Autonomie entscheidet.
Ich habe mich dabei ertappt, wie ich anfangs vor allem auf die Modellwahl geschaut habe. Welches System, welcher Anbieter, welche Benchmark. Wer wäre das nicht. Aber die Modellwahl war nie das Problem. Das Problem war immer, dass das Warum hinter einer Entscheidung nirgends stand, wo eine Maschine es lesen kann.
## Das unbequeme Anreiz-Dilemma
Jetzt kommt der Teil, den die meisten Folien geflissentlich auslassen. Wer tazites Wissen kodifizieren will, muss Menschen dazu bringen, genau das aufzuschreiben, was sie unentbehrlich macht. Du bittest jemanden, freiwillig die Quelle seiner eigenen Unersetzbarkeit zu Protokoll zu geben.
Das ist keine Datenfrage. Das ist eine Vertrauensfrage. Und sie wird gern als Datenfrage verkleidet, weil eine Datenfrage einfacher klingt.
Wer das Dilemma ignoriert, bekommt zwei Sorten Antwort: nichts oder das Falsche. Entweder der Erfahrungsträger schweigt. Oder er schreibt eine geschönte Version auf, die ihn gut aussehen lässt und den Agenten in die Irre führt. Es entsteht kein sauberer Kontext. Es entsteht kuratierte Selbstdarstellung.
Die einzige ehrliche Antwort darauf ist eine Aufwertung, keine Drohung. Wer sein Wissen kodifiziert, wird zur Autorität über das System, nicht zu seinem nächsten Einsparposten. Vom Wissensträger zum Wissens-Architekten. Diese Botschaft muss stimmen, sonst stimmt der Kontext nicht. Tazites Wissen lässt sich ohnehin nie vollständig heben. Der Mensch bleibt Letztentscheider, weil ein Rest immer in ihm bleibt.
## Was wir nicht wissen
Eine Frage bleibt offen, und ich will sie nicht glattbügeln. Wir wissen nicht, wie viel taziten Wissens sich überhaupt sinnvoll kodifizieren lässt, bevor der Aufwand den Nutzen frisst. Vielleicht sind es achtzig Prozent. Vielleicht zwanzig. Vielleicht ist die Grenze von Fachgebiet zu Fachgebiet so verschieden, dass jede Pauschalzahl Unsinn wäre.
Was wir wissen: Die Grenze der sinnvollen Autonomie liegt genau dort, wo der kodierte Kontext endet. Nicht einen Schritt weiter. Wo der Kontext aufhört, fängt das selbstbewusste Falsche an.
## Der Weg nach vorn
Bevor das nächste Agenten-Pilotprojekt startet, investiere in Kontext statt in Modelle. Das ist unspektakulär. Es ist trotzdem der einzige Hebel, der trägt.
**Ownership statt Freiwilligkeit.** Kontext braucht benannte fachliche Eigentümer und eine zentrale, kuratierende Instanz. Freigabe über ein definiertes Verfahren, nicht nach Tageslaune.
**Das Anreiz-Dilemma offen behandeln.** Wissen aufzuschreiben muss sichtbar belohnt und als Aufwertung erlebt werden. Wer das als reines Datenprojekt fährt, bekommt Lücken, wo die wichtigsten Regeln stehen müssten.
**Eine kuratierte Quelle statt vieler Kopien.** Ein Begriff, eine governte Definition. Sonst entsteht der nächste Silo, nur diesmal maschinenlesbar und dadurch noch gefährlicher.
**Integrität schützen.** Behandle Kontext-Assets wie sicherheitsrelevanten Code: Versionierung, Audit-Trails, rollenbasierte Schreibrechte, Vier-Augen-Freigabe. Wer falsche Kontextregeln einschleust, lenkt den Agenten gezielt in die Irre. In einer Sicherheitsorganisation ist das kein Randthema. Es ist der Kern.
**Graceful failure.** Wo der kodierte Kontext endet, übernimmt bewusst der Mensch. Nicht als Notnagel. Als geplante Letztinstanz. Das gilt erst recht im hoheitlichen Kontext, wo kein Algorithmus die finale Entscheidung trifft und jede Entscheidung vor Gericht erklärbar sein muss.
Eine Randnotiz, die keine ist: Dieses kodifizierte Eigenwissen ist ein souveränes Asset. Eine fertige Kontextschicht kann man nirgends kaufen. Genau das macht sie wertvoll. Sie bleibt im Haus oder sie existiert nicht.
## Fazit
Autonome Agenten werden vieles besser machen. Sie werden nichts besser machen für Organisationen, die ihr eigenes Wissen nie aufgeschrieben haben. Das ist die Pointe: Je autonomer du das System machen willst, desto abhängiger wirst du von genau den Menschen, die du ersetzen wolltest. Autonomie wird verdient, nicht gekauft. Auch nicht mit dem klügsten Agenten.
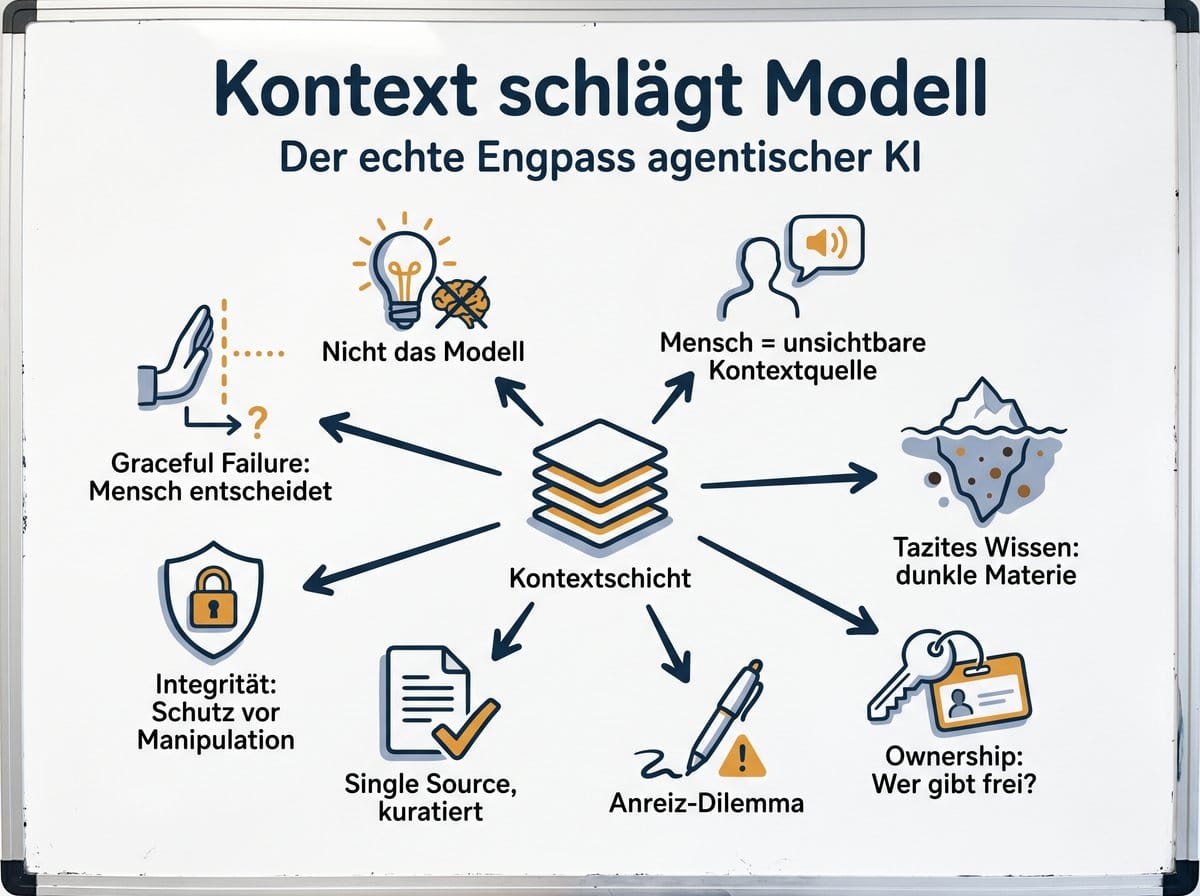
## Quick-Check
✅
****Kontext vor Modell.** Prüffrage: Steht das Warum hinter euren Entscheidungen irgendwo, wo eine Maschine es lesen kann? Wenn nein, automatisierst du keine Kompetenz, sondern eine Lücke.
✅
****Anreiz-Dilemma.** Prüffrage: Haben deine Erfahrungsträger einen Grund, ihr Wissen ehrlich aufzuschreiben statt geschönt? Ohne Aufwertung bekommst du Selbstdarstellung statt Kontext.
✅
****Graceful failure.** Prüffrage: Ist definiert, wo der kodierte Kontext endet und der Mensch übernimmt? Wo das fehlt, handelt der Agent selbstbewusst über seine Wissensgrenze hinaus.
✅
**Integrität.** Prüffrage: Sind eure Kontext-Assets versioniert, signiert und vor Manipulation geschützt? Wer den Kontext vergiftet, steuert den Agenten, nicht du.
✅
****Single Source.** Prüffrage: Hat jeder zentrale Begriff genau eine governte Definition, oder kursieren mehrere Wahrheiten? Widersprüchlicher Kontext macht den Agenten nicht vorsichtig, sondern willkürlich.
✅
****Context Poisoning.** Prüffrage: Gibt es rollenbasierte Schreibrechte und eine Vier-Augen-Freigabe für alles, was der Agent als verbindlich behandelt? Eine einzige eingeschleuste Regel reicht, damit ein korrekt arbeitendes System das Falsche tut.
✅
****Letztentscheidung.** Prüffrage: Ist klar definiert, wo der kodierte Kontext endet und der Mensch übernimmt? Tazites Wissen lässt sich nie vollständig heben, und genau dort braucht es den Letztentscheider.
---
Agentic AI: The flight to the wrong Portland by Andreas Lezgus
Autonomy Is a Property of Context, Not of the Model
[Read on Substack](https://substack.lezgus.de/p/agentic-ai-the-flight-to-the-wrong?ref=lezgus.de)
### KI-Governance als Code: Warum Richtlinien autonome Agenten nicht aufhalten.
URL: https://www.lezgus.de/ki-governance-als-code-warum-richtlinien-autonome-agenten-nicht-aufhalten/
Last updated: 2026-07-05T13:02:39.000Z
Governance-Richtlinien, Review-Boards, Genehmigungsprozesse. Drei Instrumente, die seit Jahrzehnten funktionieren. Und drei Instrumente, die in dem Moment versagen, in dem der erste autonome KI-Agent eine Entscheidung in Millisekunden trifft. Die Frage ist nicht mehr, ob du Governance brauchst. Die Frage ist, ob deine Governance schnell genug ist, um überhaupt noch relevant zu sein.
## Die Entscheidung, die jetzt ansteht
Du leitest eine IT-Organisation, die gerade ihre ersten KI-Agenten pilotiert. Dein Enterprise-Architecture-Team pflegt Referenzmodelle, Architekturprinzipien und ein Review-Board, das viermal im Jahr zusammenkommt. Das hat funktioniert, solange Menschen die Entscheidungen getroffen haben. KI-Agenten lesen aber keine Richtlinien. Sie führen Code aus. Und sie warten nicht auf den nächsten Board-Termin.
Der demografische Wandel macht die Lage dringlicher als die meisten Organisationen wahrhaben wollen. In vielen Behörden und Unternehmen existieren die wichtigsten Geschäftsregeln nicht in Dokumenten. Sie stecken in Köpfen. Sie werden in Flurgesprächen weitergegeben, in informellen Abstimmungen verfeinert, beim Kaffee erklärt. Die Kollegin, die seit dreißig Jahren weiß, welche Datenkategorien nie an externe Systeme übergeben werden dürfen, hat dieses Wissen nie aufgeschrieben. Es war nie nötig. Sie war ja da.
In fünf Jahren ist sie im Ruhestand. Und dann? Nichts von diesem Wissen ist maschinenlesbar. Nichts davon überlebt den Generationenwechsel, wenn niemand es vorher in eine Form gebracht hat, die ein autonomes System interpretieren kann. Das ist keine abstrakte Gefahr. Das ist ein konkreter Wissensverlust, der in den Altersstrukturen vieler Organisationen bereits eingepreist ist.
Viele der CIOs weltweit planen, in den nächsten Jahren KI-Agenten produktiv einzusetzen. Klingt nach Aufbruch. Die unbequeme Realität dahinter: Die wenigsten haben ihre Governance-Regeln in einer Form, die ein autonomer Agent verstehen und befolgen kann. Sie planen autonome Systeme, steuern sie aber weiterhin mit Handbüchern und Quartalsberichten. Das ist kein technisches Problem. Das ist eine Führungsentscheidung. Und sie wartet nicht auf die nächste Board-Sitzung.
## Was passiert, wenn die Governance nicht mitkommt
Ein autonomer Agent, der Daten verarbeitet, Empfehlungen ausspricht oder Transaktionen initiiert, braucht klare Grenzen. Nicht als PDF in einem SharePoint-Ordner. Nicht als Folie in einer Lenkungsausschuss-Präsentation. Sondern als versionskontrollierter Code, der physisch verhindert, dass eine Aktion außerhalb des erlaubten Rahmens stattfindet.
Das Zielbild lässt sich mit einer Lava-Lampe beschreiben. Die fließenden Blasen sind die KI-Agenten mit ihrer nichtdeterministischen Logik, ihrem Reasoning, ihrer Fähigkeit, kreativ und überraschend zu handeln. Das Glas drumherum sind die codierten Constraints: unveränderlich, deterministisch, nicht verhandelbar. Die Agenten dürfen denken, was sie wollen. Handeln dürfen sie nur innerhalb des Glases. Ohne das Glas gibt es keine Lava-Lampe. Nur Chaos auf dem Teppich.
Was passiert, wenn dieses Glas fehlt. Review-Boards, die viermal im Jahr tagen, verzögern Entscheidungen regelmäßig um ein halbes Jahr oder länger. Ein Schiebe-Beschluss hier, eine ergänzende Prüfung dort, ein Verweis an ein anderes Gremium beim übernächsten Termin. Während das Board berät, dreht sich die Technologie weiter. Die Organisation steuert nicht mehr. Sie reagiert. Im günstigsten Fall. Im ungünstigsten Fall bemerkt sie gar nicht, dass autonome Systeme längst Entscheidungen treffen, die kein Gremium je gesehen hat.
Policy-as-Code dreht diese Logik um. Statt Regeln in Sitzungen zu besprechen und per Beschluss freizugeben, werden sie als maschinenlesbare Logik bereitgestellt. Wie Software: mit Tests, mit Versionierung, mit automatischer Durchsetzung in Echtzeit. Die Governance wird zum Teil des Systems. Nicht zur externen Kontrollinstanz, die immer drei Monate zu spät kommt.
Konkret bedeutet das: Eine Regel wie "Keine personenbezogenen Daten an externe Schnittstellen ohne Freigabe" wird nicht mehr als Absatz in einem Governance-Dokument formuliert. Sie wird als Constraint in den Agenten-Code eingebettet. Der Agent kann diese Grenze nicht überschreiten, weil der Code es physisch verhindert. Nicht weil er die Richtlinie gelesen hat. Sondern weil die Richtlinie Teil seiner Architektur ist.
Das verändert die Rolle der Enterprise Architecture fundamental. Der EA-Lead ist nicht länger Bibliothekar, der Referenzmodelle in einem Repository pflegt und Architektur-Reviews moderiert. Er wird zum Autor digitaler Gesetze. Gesetze, die bestimmen, was ein Agent darf, was er eskalieren muss und was physisch unmöglich gemacht wird. Die Qualität dieser Gesetze entscheidet über die Sicherheit der gesamten Organisation. Das ist eine andere Verantwortung als die Pflege eines Architektur-Wikis.
Die größte Hürde ist dabei nicht die Technik. Es ist die Kultur. In den meisten Organisationen versteht sich das Governance-Team als Gatekeeper, als die Instanz, die "Nein" sagt. Policy-as-Code verlangt das Gegenteil: nicht "Nein", sondern "Ja, innerhalb dieser Grenzen". Vom Verhinderer zum Enabler. Das klingt nach einer Nuance. In der Praxis ist es ein Paradigmenwechsel, der an das Selbstverständnis ganzer Abteilungen rührt.
Ich habe mich dabei ertappt, diesen Wandel zu unterschätzen. Wer dreißig Jahre lang in einem System gearbeitet hat, das Governance als Prüfinstanz versteht, kann den Rollenwechsel nicht per Memo verordnen. Er muss ihn vorleben. Und das bedeutet, als Führungskraft zuerst die eigene Haltung zu ändern, bevor man sie von Teams erwartet.
## Was du jetzt konkret tun kannst
Der Weg zu codierter Governance muss nicht mit einem Großprojekt beginnen. Er kann mit vier konkreten Schritten starten, die in den nächsten Wochen umsetzbar sind.
**Beginne mit drei Regeln, nicht mit dreißig.** Identifiziere die drei Governance-Regeln, deren Verletzung den größten Schaden anrichten würde. Zugriffsrechte auf kritische Daten, Budgetgrenzen für autonome Beschaffungen, Klassifizierungsvorgaben für sensible Informationen. Codiere sie als maschinenlesbare Constraints. Der Nachweis, dass codierte Governance funktioniert, wiegt mehr als ein vollständiges Regelwerk, das nie fertig wird. Drei funktionierende Regeln sind besser als dreihundert dokumentierte. Und sie liefern das Argument für die nächsten dreißig.
**Schaffe die Rolle des Governance-Engineers.** Wer schreibt die Governance-Regeln als Code? Wer reviewed sie? Wer deployt sie in die Agentenumgebung? In den meisten Organisationen existiert diese Rolle nicht. Sie gehört nicht allein in die IT-Abteilung. Die fachliche Expertise derer, die die Regeln seit Jahrzehnten leben, muss einfließen. Sonst entsteht technisch korrekter Code, der fachlich am Ziel vorbeigeht. Die Erfahrenen bringen das Domänenwissen. Die Jüngeren bringen die technische Umsetzung. Keiner ersetzt den anderen. Beide sind unverzichtbar.
**Adressiere die Ängste systematisch.** Der demografische Wandel erzeugt eine doppelte Unsicherheit. Erfahrene Mitarbeitende fragen sich, ob ihr Wissen in Code gegossen und sie dann überflüssig werden. Jüngere Kolleginnen und Kollegen fragen sich, ob sie die fachlichen Regeln überhaupt durchdringen, die sie codieren sollen. Change-Teams müssen beiden Gruppen eine gemeinsame Übersetzungsarbeit ermöglichen. Das ist keine Einmalveranstaltung. Das ist ein fortlaufender Prozess, der begleitet, moderiert und wertgeschätzt werden muss. Die Botschaft muss lauten: Euer Wissen wird nicht ersetzt. Es wird haltbar gemacht.
**Mache die Governance auditierbar.** Ein oft übersehener Vorteil von Policy-as-Code: Jede Änderung an einer Governance-Regel wird versioniert. Wer hat wann warum eine Regel geändert? Welche Agenten-Entscheidungen wurden durch welche Constraints begrenzt? In regulierten Umgebungen ist diese Nachvollziehbarkeit kein Nice-to-have. Sie ist eine Pflicht, die mit codierten Regeln leichter zu erfüllen ist als mit jeder dokumentenbasierten Governance.
Die Frage, welche Rolle Führungskräfte bei dieser Übersetzungsarbeit einnehmen, ist noch weitgehend offen. Moderator? Auftraggeber? Qualitätsprüfer? Die Antwort wird sich von Organisation zu Organisation unterscheiden. Aber die Frage muss jetzt gestellt werden. Nicht beim nächsten Review-Board in drei Monaten. Bis dahin hat sich die Technologielandschaft schon wieder verändert. Und die Erfahrungsträger sind dem Ruhestand wieder ein Quartal näher.
## Fazit
Governance als Code ist kein IT-Projekt. Es ist die Entscheidung, ob deine Organisation in einer Welt autonomer Agenten die Regeln schreibt oder den Regeln hinterherläuft, die andere geschrieben haben. Fang mit drei Regeln an. Fang diese Woche an. Die Richtlinien in deinem SharePoint-Ordner werden keinen KI-Agenten aufhalten. Drei Zeilen deterministischer Code schon.
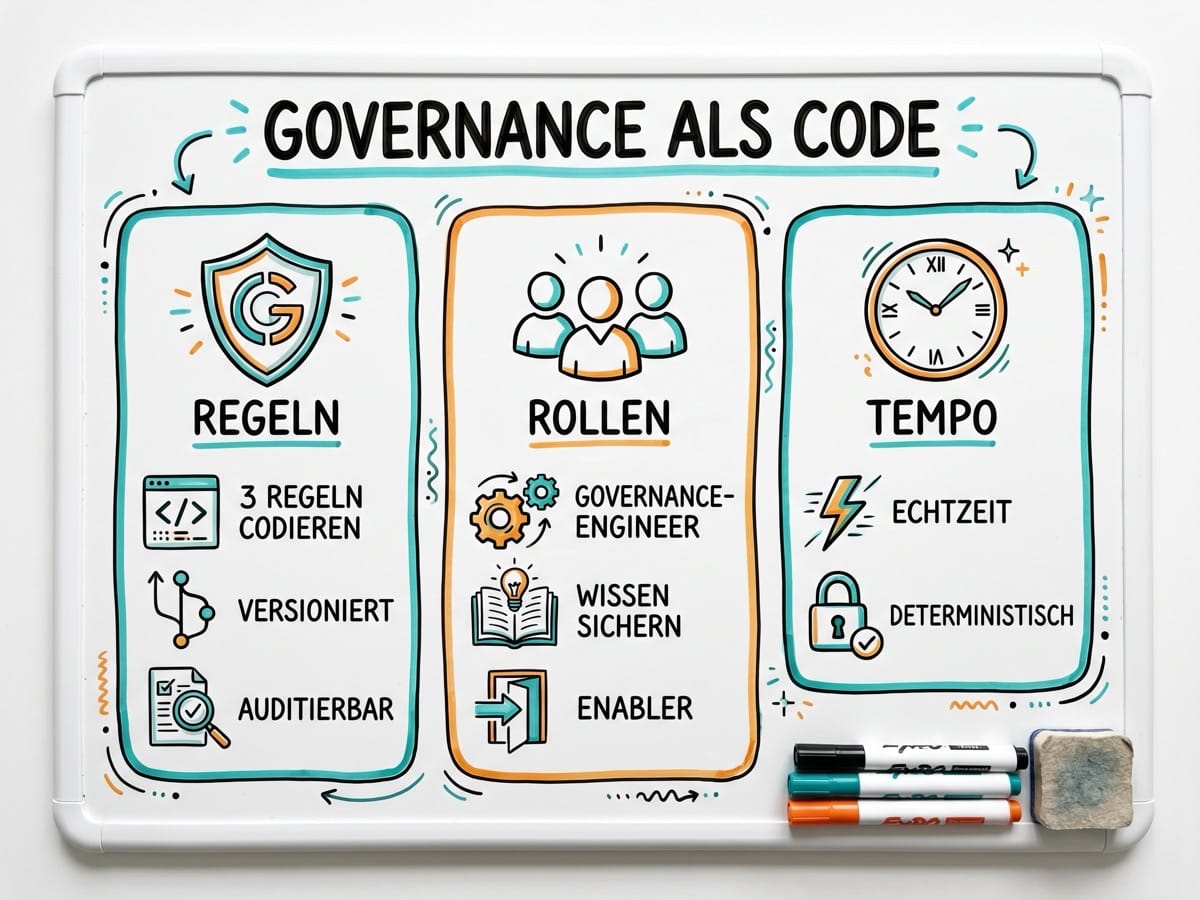
✅
****Maschinenlesbare Governance**. Wenn dein nächster KI-Agent eine Entscheidung trifft: Kann er deine Governance-Regeln lesen - oder nur du? **Agenten ignorieren Regeln nicht aus böser Absicht. Sie kennen nur die Regeln, die in ihrer Sprache geschrieben sind.*
✅
****Review-Board-Geschwindigkeit**. Wie lange dauert eine Governance-Entscheidung in deiner Organisation - von der Identifikation bis zur Umsetzung? **Wenn die Antwort "Monate" lautet, ist deine Governance langsamer als die Technologie, die sie steuern soll.*
✅
****Demografische Wissenssicherung**. Welche deiner wichtigsten Governance-Regeln existieren nur in den Köpfen erfahrener Mitarbeitender? **Erfahrungswissen, das nicht codiert wird, geht mit den Menschen in den Ruhestand. Kein Agent kann Flurgespräche auswerten.*
✅
****Governance-Engineering-Rolle**. Gibt es in deiner Organisation eine definierte Verantwortung dafür, Governance-Regeln als Code zu schreiben und zu deployen? **Ohne klare Zuständigkeit wird Governance-Code entweder nicht geschrieben oder von Teams allein verfasst, denen der fachliche Kontext fehlt.*
✅
****Enabler statt Gatekeeper**. Wenn dein EA-Team auf eine Anfrage reagiert: Lautet die erste Antwort "Nein" oder "Ja, innerhalb dieser Grenzen"? **Policy-as-Code verlangt den Rollenwechsel. Wer nur verhindert, wird von autonomen Systemen umgangen.*
✅
****Auditierbarkeit**. Kannst du nachweisen, wer wann welche Governance-Regel geändert hat und welche Agenten-Entscheidungen dadurch beeinflusst wurden? **Codierte Regeln sind versioniert und nachvollziehbar. Dokumentenbasierte Governance ist es meistens nicht.*
---
Governance as Code or Not at All by Andreas Lezgus
Why more governance boards won't save you from autonomous agents.
[Read on Substack](https://substack.lezgus.de/p/governance-as-code-or-not-at-all?ref=lezgus.de)
### Vertragliche Souveränität: Warum dein Vertrag dein tatsächliches Souveränitätsniveau bestimmt.
URL: https://www.lezgus.de/vertragliche-souveranitat-warum-dein-vertrag-dein-tatsachliches-souveranitatsniveau-bestimmt-mit/
Last updated: 2026-07-05T13:00:26.000Z
Verträge, Jurisdiktionen, Subunternehmer, Aufkäufe. Vier Begriffe, die in keiner Souveränitätsdebatte eine Rolle spielen - und die trotzdem darüber entscheiden, ob deine Organisation morgen noch handlungsfähig ist. Warum reden alle über souveräne Cloud-Infrastruktur, aber niemand über die Verträge, die sie absichern sollen?
## Das Vertragsproblem, über das keiner spricht
Die Debatte über digitale Souveränität dreht sich um Rechenzentren, Open-Source-Alternativen und europäische Cloud-Anbieter. Das ist nicht falsch. Aber es greift zu kurz.
Die technische Infrastruktur ist nur so souverän wie der Vertrag, der sie regelt. In regulierten Umgebungen erlebe ich das seit Jahren: Organisationen investieren erhebliche Mittel in souveräne Infrastruktur -- und unterschreiben gleichzeitig Verträge, die keinen einzigen Mechanismus enthalten, um Datenresidenz zu überprüfen, Subunternehmer-Wechsel zu kontrollieren oder im Krisenfall den Anbieter zu wechseln. Der Vertrag sagt "Daten in Deutschland". Ob das stimmt, weiß niemand. Weil niemand nachsieht.
Das Problem hat eine neue Dimension bekommen. Im KI-Bereich werden innovative Startups in atemberaubendem Tempo von amerikanischen oder chinesischen Konzernen aufgekauft. Dein Vertragspartner von gestern gehört morgen einem Unternehmen, das unter einer völlig anderen Rechtsordnung operiert. Und dein Vertrag? Hat keine Klausel für diesen Fall. Deine Daten sind trotzdem dort.
Klingt nach Zukunft. Ist Gegenwart. Und die Frage ist nicht, ob es passiert. Die Frage ist, ob dein Vertrag darauf vorbereitet ist.
Es ist nicht ausreichend die technische Seite der Souveränität für die Entscheidende zu halten. Rechenzentrum in Deutschland, europäischer Anbieter, offene Standards. Alles richtig. Alles notwendig. Aber nicht hinreichend. Denn die eigentliche Verwundbarkeit sitzt nicht nur in der Infrastruktur. Sie sitzt auch im Kleingedruckten.
## Fünf Stufen vertraglicher Souveränität
Die meisten Organisationen glauben, ihre Verträge schützen sie. Ein ehrliches Reifegrad-Modell zeigt, wo du tatsächlich stehst - und wie weit der Weg ist.
**Stufe 1 - Implizit.** Souveränität wird vorausgesetzt, aber nirgends vertraglich fixiert. Dein Anbieter speichert die Daten "irgendwo in der EU". Du vertraust darauf. Bis du es nicht mehr kannst. Eine Vielzahl der Verträge bewegen sich auf diesem Niveau. Nicht aus böser Absicht. Aus Gewohnheit.
**Stufe 2 - Reaktiv.** Es gibt Standard-Klauseln aus der allgemeinen Anbieter-Vorlage. Datenresidenz steht drin, irgendwo auf Seite 47 der AGB. Monitoring existiert nicht. Compliance wird angenommen, bis ein Vorfall das Gegenteil beweist. Das ist die Komfortzone - und sie ist gefährlich, weil sie Kontrolle suggeriert, die nicht existiert. Der Unterschied zu Stufe 1 ist kosmetisch.
**Stufe 3 - Definiert.** Hier beginnt echte Souveränität. Maßgeschneiderte Klauseln sind Teil des Vertrags: Datenresidenz mit konkreten Standorten, Subunternehmer-Transparenz mit Genehmigungspflicht, Exit-Mechanismen mit definierten Fristen und Datenmitnahmegarantie. Überprüfung erfolgt durch periodische Audits - manuell, aber systematisch. Der entscheidende Unterschied zu den vorherigen Stufen: Jemand prüft, ob der Vertrag eingehalten wird. Nicht einmal im Jahr. Regelmäßig.
**Stufe 4 - Gesteuert.** Souveränitätskontrollen werden aktiv und kontinuierlich durchgesetzt. Dashboards zeigen den Compliance-Status. Drittanbieter-Risikobewertungen sind integriert. Geopolitische Risikobewertung ist ein fester Tagesordnungspunkt im Lieferanten-Review - nicht als Pflichtübung, sondern als Frühwarnsystem. Organisationen auf dieser Stufe erkennen einen Subunternehmer-Wechsel, bevor er wirksam wird.
**Stufe 5 - Dynamisch.** Automatisiertes Monitoring aller vertraglichen Souveränitätsverpflichtungen. Änderungen in Rechtsräumen oder Unternehmensstrukturen werden erkannt und lösen definierte Eskalationsprozesse aus. Die Organisation reagiert nicht auf Vorfälle. Sie erkennt Verschiebungen, bevor sie zu Vorfällen werden. Das europäische SEAL-Framework für Cloud-Souveränität weist in diese Richtung. Der Gedanke dahinter ist richtig: Souveränität ist kein Zustand, sondern eine kontinuierliche Fähigkeit. Nur müsste dieser Ansatz auf alle IT-Verträge ausgedehnt werden, nicht nur auf Cloud-Dienste.
Der Sprung von Stufe 2 auf Stufe 3 ist der kritischste. Er erfordert keine neue Technologie. Er erfordert eine Entscheidung: Wollen wir unsere Souveränität vertraglich durchsetzen - oder nur dokumentieren? Die meisten Organisationen scheuen diesen Schritt, weil er Verhandlungsmacht voraussetzt und Konflikte mit Anbietern bedeutet. Aber genau das ist der Punkt. Digitale Souveränität heißt: Deine Ermittlungswerkzeuge funktionieren auch dann noch, wenn ein Anbieter seine Lizenzpolitik ändert. Deine Daten bleiben in deiner Hoheit, auch wenn ein Konzern den Eigentümer wechselt. Kein Drittanbieter kann dich per Vertragsklausel handlungsunfähig machen. Das muss im Vertrag stehen. Nicht im Strategiepapier.
Die ehrliche Diagnose: Die meisten Organisationen, die ich kenne, operieren auf Stufe 1 oder 2\. Sie haben Verträge mit Souveränitätsbezug, aber keine Verträge mit Souveränitätswirkung. Es entsteht kein Schutz. Es entsteht Dokumentation. Der Unterschied entscheidet darüber, was passiert, wenn ein Subunternehmer wechselt, ein Startup aufgekauft wird oder eine Regierung ihre Rechtsprechung ausweitet.
## Wer steuert, wenn der Vertrag schweigt?
Ein guter Vertrag allein reicht nicht. Ohne aktive Governance ist er eine Absichtserklärung, kein Schutzschild.
Vertragliche Souveränität braucht klare Verantwortlichkeiten - quer durch die Organisation. Vier Aufgaben, die jemand konkret verantworten muss: die laufende Definition und Aktualisierung der Souveränitätsanforderungen, das kontinuierliche Monitoring der Vertragseinhaltung, die geopolitische Risikobewertung mit Auswirkungsanalyse auf bestehende Verträge, und die Incident Response bei Souveränitätsverletzungen. Letztere braucht konkrete Eskalationspfade für den Fall, dass ein Anbieter aufgekauft wird oder Daten plötzlich einer anderen Jurisdiktion unterliegen.
Viele Organisationen haben regelmäßig diese Aufgaben keinem konkreten Team zugeordnet. Die IT denkt, Recht kümmert sich. Recht denkt, die Beschaffung hat es im Vertrag geregelt. Die Beschaffung denkt, die IT überwacht. Niemand überwacht.
Das Ergebnis: Der erste Kontakt mit der Realität findet statt, wenn der Schaden bereits eingetreten ist. Ein Subunternehmer wurde gewechselt. Die Daten liegen in einer anderen Jurisdiktion. Und niemand hat eine Handlungsanweisung. Nicht weil der Vertrag schlecht ist. Sondern weil niemand zuständig war, ihn durchzusetzen.
Wer sich jetzt fragt, ob das in seiner Organisation anders läuft: Die Probe ist einfach. Frag in deiner nächsten Sitzung, wer für die Überwachung der Souveränitätsklauseln in euren IT-Verträgen zuständig ist. Wenn die Antwort länger als drei Sekunden dauert, hast du deine Antwort.
## Warnsignale in deinen Verträgen
Bevor du den großen Umbau startest: Prüfe deine bestehenden Verträge auf diese roten Flaggen.
**Kein Exit ohne Schmerz.** Dein Vertrag enthält keine oder nur unklare Ausstiegsklauseln. Kein definierter Migrationspfad, keine Datenmitnahmegarantie, keine realistische Übergangsfrist. Du bist technisch souverän, aber vertraglich gefangen. Dein Anbieter weiß das. Und er verhandelt entsprechend.
**Subunternehmer im Nebel.** Du weißt nicht, welche Subunternehmer dein Anbieter einsetzt - oder du erfährst es erst, nachdem der Wechsel vollzogen ist. Keine Genehmigungspflicht, keine vorherige Benachrichtigung, keine Kontrolle darüber, in welcher Jurisdiktion deine Daten tatsächlich verarbeitet werden. Ein offshore Subunternehmer-Wechsel ohne dein Wissen ist keine theoretische Gefahr. Es passiert.
**Eigentümerwechsel ohne Schutz.** Dein Vertrag enthält keine Change-of-Control-Klausel. Wenn dein KI-Startup morgen von einem US- oder chinesischen Konzern übernommen wird, ändert sich vertraglich: nichts. Praktisch ändert sich alles - Rechtsraum, Datenzugriffsrechte, Geschäftspolitik, Kooperationsbereitschaft. Die Konsolidierungswelle im KI-Markt macht dieses Szenario nicht unwahrscheinlich. Sie macht es zur Frage des Zeitpunkts, nicht der Möglichkeit. Und der Zeitpunkt ist immer der falsche.
**Compliance auf Vertrauensbasis.** Dein Vertrag schreibt Datenresidenz vor, enthält aber keinen Mechanismus zur Überprüfung. Keine Audit-Rechte, keine Transparenzberichte, keine technische Verifikation. Du hoffst, dass der Anbieter sich daran hält. Das ist kein Risikomanagement. Das ist Glaube. In allen Organisationen - unabhängig ob hochreguliert oder normale Schutzbedarfe ist dieser Glaube nicht nur fahrlässig. Er ist ein Compliance-Risiko, das im Ernstfall Konsequenzen hat, die über den einzelnen Vertrag weit hinausgehen.
## Vertragliche Handlungsfähigkeit aufbauen
Drei Maßnahmen, die keinen großen Umbau erfordern - aber sofort Wirkung entfalten.
**Vertrags-Audit mit Souveränitätsfokus.** Nimm deine kritischsten IT-Verträge und prüfe sie auf die vier Warnsignale. Nicht alle auf einmal. Beginne mit den Verträgen, in denen personenbezogene oder sicherheitsrelevante Daten fließen. Eine Woche reicht für die erste Bestandsaufnahme. Danach weißt du, wo du stehst. Das ist mehr, als die meisten Organisationen von sich behaupten können.
**Modulare Vertragsbausteine.** Entwickle standardisierte Souveränitätsmodule: Datenresidenz, Subunternehmer-Governance, Change-of-Control, Exit-Management. Keine neuen Rahmenverträge. Ergänzungsmodule, die in bestehende Verträge eingebaut werden können. Das spart Verhandlungszeit und macht die Anforderungen für Anbieter transparent und kalkulierbar. Ein wichtiger Baustein, der oft vergessen wird: die Pflicht zur vorherigen schriftlichen Genehmigung bei jedem Wechsel eines offshore Subunternehmers. Klingt bürokratisch. Ist aber der einzige Mechanismus, der verhindert, dass deine Daten über Nacht die Jurisdiktion wechseln.
**Crossfunktionales Governance-Team.** IT, Recht, Beschaffung und Informationssicherheit an einen Tisch. Nicht als Projektgruppe mit Ablaufdatum, sondern als dauerhaftes Gremium mit klarem Auftrag: Souveränitätsmonitoring, Eskalation, Vertragsanpassung. Die Besetzung muss verbindlich sein - mit namentlicher Zuordnung, nicht mit Rollenbeschreibungen, die jeder anders interpretiert. Ohne dieses Team bleibt jede Vertragsklausel Papier. Und Papier schützt keine Daten.
Eine Anmerkung zur Trennlinie, die in keinem Vertrag fehlen darf: Für die eigene Wissensarbeit, zum Prototyping und zur Bewertung nutze ich internationale KI-Modelle intensiv. Für regulierte Daten und den operativen Behördenbetrieb kommen sie nicht in Frage - und das muss vertraglich abgebildet sein. Diese Unterscheidung gehört in jede Leistungsbeschreibung. Explizit, nicht als implizite Annahme.
Du fragst dich, ob deine Verträge deine Organisation tatsächlich schützen? Prüfe es. Nicht irgendwann. Diese Woche. Die nächste Übernahme eines KI-Anbieters wartet nicht auf deinen Vertrags-Review-Zyklus. Dein Vertrag ist dein Souveränitätsniveau. Nicht dein Rechenzentrum.
## Quick Check: Ist dein Vertrag auf Digitale Souveranität vorbereitet?
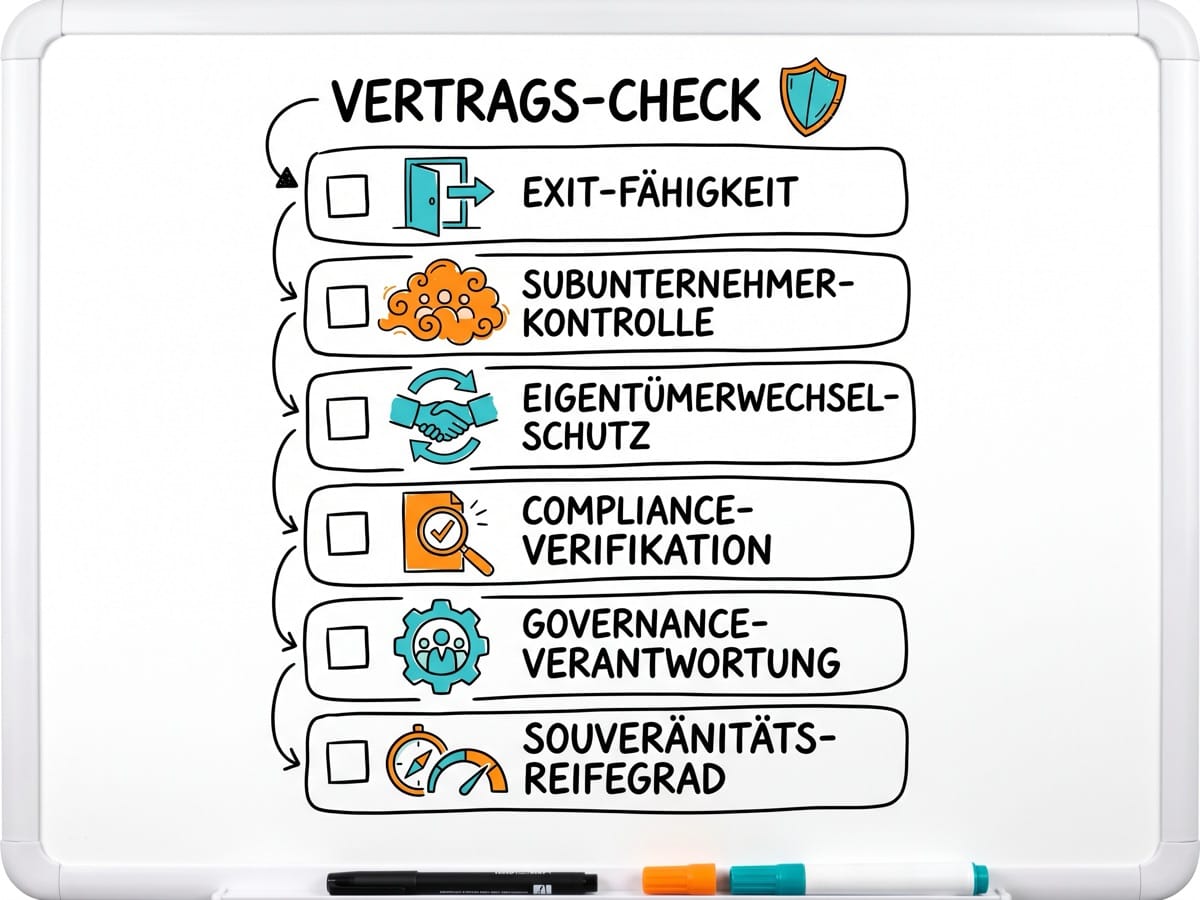
Checke Deine Verträge.
✅
****Exit-Fähigkeit**. Enthält dein Vertrag einen definierten Migrationspfad mit Datenmitnahmegarantie und realistischer Übergangsfrist? **Ohne Exit-Klausel bist du technisch souverän, aber vertraglich gefangen – und dein Anbieter weiß das.*
✅
****Subunternehmer-Kontrolle**. Hast du Genehmigungspflicht und Benachrichtigungsrecht bei jedem Subunternehmer-Wechsel vertraglich verankert? **Jeder unkontrollierte Subunternehmer-Wechsel kann deine Daten über Nacht in eine andere Jurisdiktion verschieben.*
✅
****Change-of-Control-Schutz**. Gibt es eine Vertragsklausel, die dir Sonderkündigungsrechte oder Neuverhandlung einräumt, wenn dein Anbieter übernommen wird? **Im KI-Markt werden Startups in Monaten aufgekauft. Ohne Change-of-Control-Klausel entscheidet der neue Eigentümer über deine Daten.*
✅
****Compliance-Verifikation**. Hast du vertragliche Audit-Rechte und technische Mechanismen, um Datenresidenz tatsächlich zu überprüfen? **Compliance auf Vertrauensbasis ist kein Risikomanagement. Es ist Hoffnung mit Unterschrift.*
✅
****Governance-Verantwortung**. Ist ein crossfunktionales Team benannt, das Souveränitätsanforderungen definiert, überwacht und bei Verstößen eskaliert? **Wenn IT, Recht und Beschaffung jeweils denken, die anderen kümmern sich, kümmert sich niemand.*
✅
****Souveränitäts-Reifegrad**. Kannst du dein aktuelles Souveränitätsniveau auf einer Skala von 1 bis 5 einordnen – und weißt du, wo du in 12 Monaten stehen willst? **Ohne Standortbestimmung kein Zielbild. Ohne Zielbild keine Priorisierung der Vertragsmaßnahmen.*
---
Sovereignty ends where your contract is silent by Andreas Lezgus
The contract clause nobody checks.
[Read on Substack](https://substack.lezgus.de/p/sovereignty-ends-where-your-contract?ref=lezgus.de)
### KI-Kontext als kritische Infrastruktur: Warum deine Datenstrategie ein Fundament-Problem hat
URL: https://www.lezgus.de/ki-kontext-als-kritische-infrastruktur-warum-deine-datenstrategie-ein-fundament-problem-hat/
Last updated: 2026-07-05T13:01:16.000Z
Viermal mehr Budget für Fundamente als für Tools. So viel investieren Organisationen, die mit KI tatsächlich messbare Ergebnisse erzielen. Nicht doppelt so viel. Vierfach. Was, wenn dein nächstes Strategiegespräch genau an dieser Stelle die falsche Frage stellt?
## Die Budgetentscheidung, die niemand so formuliert
Du kennst die Situation. Die Präsentation zum neuen KI-Vorhaben liegt auf dem Tisch. Beeindruckende Demos, ein Anbieter mit gutem Namen, ein Projektplan mit Meilensteinen. Die Frage im Raum lautet: Machen wir das? Die richtige Frage lautet anders: Haben wir die Datengrundlage, damit das überhaupt funktionieren kann?
Die meisten Organisationen kaufen Analysewerkzeuge, bevor sie ihre Daten in einen Zustand gebracht haben, der Analyse überhaupt zulässt. Das klingt banal. In der Praxis bedeutet es: Millionenbudgets für Plattformen, die auf unstrukturierte, nicht gelabelte, kontextlose Datenbestände losgelassen werden. Das Ergebnis ist vorhersehbar.
Der eigentliche Engpass ist nicht das Modell. Der Engpass ist der Kontext. Eine strukturierte Kontextschicht, bestehend aus semantischen Zuordnungen, Ontologien und maschinenlesbaren Regeln, reduziert den Rechenaufwand von KI-Systemen um den Faktor zwei bis drei. Bei gleicher oder besserer Genauigkeit. Kontext ist kein Nice-to-have. Kontext ist Infrastruktur.
## Was in der Strategievorlage fehlt
**Die Datenbasis-Frage** geht tiefer als haben wir genug Daten? Entscheidend ist: Sind die Daten semantisch zugeordnet? Wissen Systeme, was ein Datensatz bedeutet, nicht nur wo er liegt? Ohne diese Zuordnung produziert jedes KI-System bestenfalls Rauschen, schlimmstenfalls falsche Gewissheiten.
Dann die Frage nach der Wiederverwendbarkeit. Wenn dein Datenteam für jedes neue Vorhaben die gleichen Daten neu aufbereiten muss, fehlt die Kontextschicht. Eine einmal aufgebaute semantische Infrastruktur wirkt wie ein Multiplikator: jede neue Anwendung, die darauf zugreift, muss nicht bei null anfangen.
Die Governance-Frage wird gern als Compliance-Thema abgeheftet. Dabei ist sie eine Architekturfrage. Organisationen, die ihr Governance-Team aktiv in die KI-Datenbereitstellung einbinden, erzielen dreimal häufiger hohe gute Ergebnisse als solche, die Governance reaktiv betreiben. Dreimal. Governance ist kein Bremser. Governance ist Katalysator.
Schließlich die Kompetenzfrage. Wer betreibt diese Infrastruktur? Die Rolle verändert sich fundamental: weg vom reaktiven Datenverwalter, hin zum strategischen Schiedsrichter, der Datenqualität, Kontexttreue und Regelkonformität in Echtzeit sicherstellt. Das ist eine Führungsaufgabe, keine Stellenbeschreibung für die IT-Abteilung.
## Warum Sicherheitsbehörden das zuerst verstehen
In hochregulierten Umfeldern gibt es keine Grauzone. Ohne kontextuelle und semantische Zuordnung von Einzeldaten ist eine Analyse aufgrund verfassungsrechtlicher Schranken schlicht nicht zulässig. Kein Labeling und kein Kontext, keine übergreifende und rechtlich abgesicherte Analyse. Punkt.
Das ist keine bürokratische Hürde. Das ist eine Designentscheidung, die den Rest der Architektur bestimmt. Wer hier zuerst investiert, statt auf Tool-Versprechen zu setzen, baut eine Grundlage, die jede künftige KI-Anwendung tragen kann. Wer es umgekehrt versucht, wird feststellen: Die teuerste Lizenz nützt nichts, wenn die Daten nicht in einem Zustand sind, den die Verfassung für eine Auswertung voraussetzt.
Diese Erfahrung aus dem Sicherheitsbereich ist übertragbar. Jede Organisation, die mit sensiblen Daten arbeitet, und das sind die meisten, steht vor derselben Grundsatzfrage: Investiere ich in das Werkzeug oder in das Fundament, auf dem das Werkzeug steht?
## Was du in den nächsten vier Wochen tun kannst
**Kontext-Audit durchführen.** Nimm dein letztes KI-Vorhaben. Frag: Wie viel Prozent der Projektzeit floss in Datenaufbereitung? Wenn die Antwort über 60 Prozent liegt, fehlt die Kontextschicht.
**Die Kontextschicht als Infrastruktur-Projekt deklarieren.** Knowledge Graph, semantische Schicht, Policy-as-Code: Das verdient denselben Projektstatus wie Netzwerkinfrastruktur. Mit eigenem Budget, eigener Governance, eigenem Sponsor auf Vorstandsebene.
**Stewardship-Rollen neu bewerten.** Wer in deiner Organisation ist für die Qualität und Weiterentwicklung der Kontextschicht verantwortlich? Wenn die Antwort niemand oder die IT lautet, hast du ein Führungsproblem, kein Technikproblem.
## Fazit
Die beste KI-Strategie passt auf eine Serviette: Fundamente vor Features. Kontext vor Modellen. Governance als Architektur, nicht als Audit. Alles andere ist Tool-Shopping mit Strategielabel.
## Quick Check: Ist dein Fundament bereit für die KI?
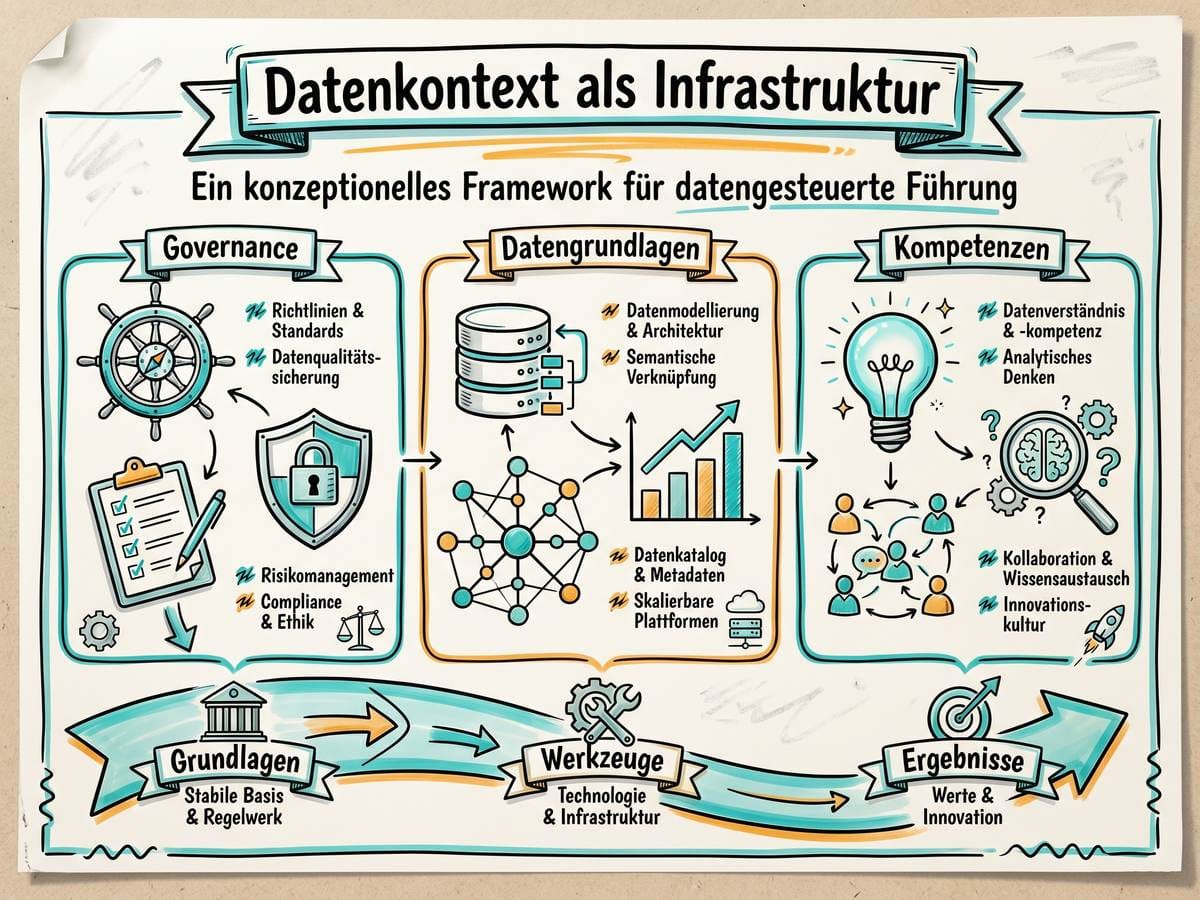
Datenkontext als kritische Infrastruktur
✅
****Semantische Zuordnung**. Sind deine Datenbestände so gelabelt, dass ein KI-System die Bedeutung einzelner Datenpunkte ohne menschliche Nacharbeit versteht? **Ohne semantische Zuordnung produzieren KI-Modelle Ergebnisse auf Basis von Struktur statt Bedeutung - das Ergebnis ist technisch korrekt, aber inhaltlich wertlos.*
✅
****Wiederverwendbarkeit**. Muss dein Datenteam für jedes neue KI-Vorhaben die gleichen Daten von Grund auf neu aufbereiten? **Fehlende Kontextschicht bedeutet: Jedes Projekt startet bei null. Der Multiplikator-Effekt bleibt aus, die Kosten skalieren linear statt degressiv.*
✅
****Governance-Integration**. Ist dein Governance-Team aktiv in die KI-Datenbereitstellung eingebunden - oder wird es erst bei Problemen gerufen? **Reaktive Governance bremst. Integrierte Governance beschleunigt. Der Unterschied ist Faktor drei bei messbaren Geschäftsergebnissen.*
✅
****Budget-Verteilung**. Wie verteilt sich dein KI-Budget zwischen Plattform-Lizenzen und Daten-Fundamenten (Labeling, Ontologie, Kontextaufbau)? **Organisationen mit den besten KI-Ergebnissen investieren vierfach mehr in Fundamente als in Tools. Umgekehrte Verteilung ist ein Warnsignal.*
✅
****Stewardship-Verantwortung**. Gibt es eine klar benannte Person, die für Qualität und Weiterentwicklung der Kontextschicht verantwortlich ist? **Ohne klare Verantwortung verkommt die Kontextschicht zum Nebenprodukt. Sie braucht einen Eigentümer auf Führungsebene.*
✅
****Rechtliche Konformität**. Könntest du gegenüber einer Aufsichtsbehörde jederzeit nachweisen, auf welcher semantischen Grundlage eine KI-gestützte Analyse erfolgt ist? **In regulierten Umfeldern ist lückenlose Nachvollziehbarkeit keine Option. Fehlende Kontextdokumentation macht Analyseergebnisse rechtlich angreifbar.*
---
Context Is Your Next Critical Infrastructure by Andreas Lezgus
Your AI needs context, not more tools.
[Read on Substack](https://substack.lezgus.de/p/context-is-your-next-critical-infrastructure?ref=lezgus.de)
### Agentic AI im Datenmanagement: Was du brauchst, bevor der erste Agent startet
URL: https://www.lezgus.de/agentic-ai-im-datenmanagement-was-du-brauchst-bevor-der-erste-agent-startet/
Last updated: 2026-07-05T13:29:50.000Z
Autonome KI-Agenten sollen Datenpipelines bauen, Qualität in Echtzeit prüfen und Governance automatisch durchsetzen. Klingt nach Zukunft. Warum scheitern dann so viele Organisationen schon an einem aktuellen Datenkatalog?
## Die neue Verheißung
Metadaten, Datenkataloge, semantische Schichten, Echtzeit-Governance: Vier Begriffe, die in jeder aktuellen Analyse zu KI im Datenmanagement auftauchen. Die Botschaft ist klar. Autonome Agenten übernehmen die Drecksarbeit. Sie erkennen Anomalien, reparieren Pipelines, klassifizieren Daten und steuern Zugriffsrechte. Alles automatisch, alles in Echtzeit, alles kontextbewusst.
Die Prognosen lesen sich beeindruckend: Bis 2029 sollen 75 Prozent aller Data-Engineering-Workflows durch Agenten automatisiert sein. Bis 2028 werden angeblich ein Drittel aller Interaktionen mit generativer KI autonome Agenten auslösen. Die großen Plattformanbieter überbieten sich mit neuen Agent-Funktionen. Datenbanken werden zu "Knowledge Sources", ETL-Workflows zu "selbstheilenden Pipelines", und Governance-Regeln sollen sich dynamisch an den Kontext anpassen.
Die Architektur dahinter ist durchaus durchdacht. Drei Typen von Agenten sollen zusammenarbeiten: spezialisierte Task-Agenten für einzelne Aufgaben wie Bereinigung oder Transformation, Orchestrierungsagenten, die Workflows über Systemgrenzen hinweg koordinieren, und Multi-Agenten-Systeme, die all das zu einem selbstlernenden Ganzen verbinden. In der Theorie entsteht so ein Datenmanagement, das sich selbst optimiert und menschliches Eingreifen nur noch in Ausnahmefällen braucht.
Für IT-Führungskräfte klingt das nach einer strategischen Entscheidung, die keinen Aufschub duldet. Wer jetzt nicht investiert, fällt zurück. Die Frage, die in den Präsentationen fehlt: Was passiert, wenn du investierst, aber deine Organisation die Voraussetzungen nicht erfüllt?
## Was die Praxis zeigt
Ich habe in den vergangenen Jahren eines gelernt: Zwischen dem, was Analysten als nächsten Schritt empfehlen, und dem, was Organisationen tatsächlich umsetzen können, liegen oft Jahre. Manchmal Jahrzehnte. Das ist keine Klage. Das ist eine Beobachtung, die sich in jedem Technologiezyklus bestätigt hat.
Vor nicht langer Zeit startete eine große Organisation ein Datenqualitäts-Projekt. Das Ziel klang vernünftig: Datenprobleme systematisch identifizieren und beheben. Regelbasiert, automatisiert, nachvollziehbar. Das Projekt kam ins Stocken, bevor es richtig begonnen hatte. Nicht weil die Technik fehlte. Sondern weil niemand wusste, welche Daten überhaupt wo liegen und was sie bedeuten. Kein Datenkatalog. Keine maschinenlesbaren Geschäftsdefinitionen. Keine klaren Verantwortlichkeiten.
Die Qualitätsregeln konnten nicht greifen, weil ihr Bezugspunkt fehlte. Das Projekt musste einen Schritt zurück: erst inventarisieren, dann messen. Die Erkenntnis war schmerzhaft, weil sie banal klingt. Aber genau das macht sie so relevant.
Jetzt stell dir vor, was passiert, wenn du auf dieser Grundlage nicht nur regelbasierte Prüfungen aufsetzt, sondern einen autonomen Agenten. Einen Agenten, der eigenständig Zugriffsrechte anpasst. Der Daten als "nicht sensibel" klassifiziert. Der Pipelines umbaut, weil sein Modell eine Anomalie erkennt, die keine ist. Ein solcher Agent braucht eine semantische Schicht als Fundament: maschinenlesbare Geschäftsdefinitionen, konsistente Ontologien, gepflegte Metadaten. Diese Schicht verwandelt rohe Daten in Kontext. Ohne sie ist ein Agent ein Werkzeug ohne Landkarte.
In den meisten Organisationen, die ich kenne, ist diese semantische Schicht schlicht nicht vorhanden. Nicht in Ansätzen mangelhaft. Nicht vorhanden. Das bedeutet: KI-Agenten würden Prozesse auf Daten automatisieren, deren Bedeutung sie nicht kennen. Sie würden Beziehungen herstellen, die nicht existieren, und Klassifizierungen vornehmen, die auf Annahmen statt auf Wissen beruhen.
Im hochregulierten Behördenumfeld kommt eine weitere Dimension hinzu, die in keiner Produktdemo auftaucht: Verantwortung. Wenn ein Agent autonom Governance-Entscheidungen trifft, etwa zur Klassifizierung oder Zugriffssteuerung, dann ist das keine technische Frage mehr. Wer trägt die Verantwortung, wenn der Agent personenbezogene Daten falsch einstuft? Wer haftet, wenn als Verschlusssache eingestufte Informationen durch eine algorithmische Fehlklassifizierung in den falschen Bereich gelangen? Im Kontext von DSGVO und Geheimschutz ist "autonome Governance" kein Feature. Es ist ein Risiko, solange die menschliche Letztentscheidung nicht architektonisch verankert ist.
Dieses Problem wird durch die Natur der neuen Agenten verschärft. Anders als regelbasierte Systeme arbeiten sie nichtdeterministisch. Gleicher Input kann zu unterschiedlichem Output führen. Das macht sie flexibel und leistungsfähig, aber auch schwerer zu auditieren. In einem Umfeld, in dem Nachvollziehbarkeit keine Option, sondern eine rechtliche Anforderung ist, muss dieser Punkt von Anfang an in der Architektur gelöst werden.
Ich habe mich dabei ertappt, wie ich anfangs selbst fasziniert war von der Idee selbstheilender Datenpipelines. Wer wäre das nicht, nach Jahren mühsamer manueller Pflege? Aber Faszination ist kein Ersatz für eine ehrliche Bestandsaufnahme. Und ehrlich ist: Die meisten Organisationen sind nicht drei Monate, sondern drei Jahre von einem sinnvollen Einsatz autonomer Daten-Agenten entfernt.
## Was daraus folgt
Die gute Nachricht: Du musst nicht auf KI-Agenten verzichten. Du musst nur die Reihenfolge einhalten. Und die beginnt nicht mit der Agentenplattform, sondern mit vier Grundlagen, die sich nicht abkürzen lassen.
**Datenkatalog vor Automatisierung.** Wer seine Daten nicht inventarisiert hat, kann keine sinnvollen Qualitätsregeln definieren. Und ohne Qualitätsregeln hat ein Agent kein Fundament. Das klingt trivial. Trotzdem beginnen die meisten Projekte mit dem Tool statt mit den Daten. Ein pragmatischer erster Schritt: Starte nicht mit dem Anspruch, alle Daten zu katalogisieren. Starte mit den drei bis fünf Datenbereichen, die für deine kritischsten Prozesse relevant sind. Lieber fünf Prozent gut dokumentiert als hundert Prozent in einer Tabelle, die niemand pflegt.
**Human-in-the-Loop als Architekturprinzip.** Besonders in Bereichen mit hohen Compliance-Anforderungen darf die menschliche Letztentscheidung keine Notlösung sein. Sie gehört in die Systemarchitektur, nicht in eine Fusszeile im Betriebshandbuch. Jede Governance-Entscheidung, die ein Agent trifft, braucht eine definierte Eskalationsstufe. Konkret bedeutet das: Bevor du einen Agenten in Betrieb nimmst, definierst du, bei welchen Entscheidungen er autonom handeln darf, bei welchen er einen Vorschlag macht, und bei welchen er stoppt und einen Menschen einbezieht. Diese Dreistufigkeit ist kein Luxus. Sie ist die Mindestanforderung für regulierte Umgebungen.
**Definiere das Outcome, nicht das Tool.** Nicht "wir wollen KI im Datenmanagement" ist die richtige Zielsetzung. Sondern "wir wollen Datenqualitätsprobleme in Pipeline X innerhalb von vier Stunden statt vier Tagen erkennen und beheben". Erst wenn das Ziel messbar formuliert ist, lässt sich beurteilen, ob ein Agent die richtige Lösung ist oder ob ein gut konfiguriertes Regelwerk ausreicht.
Und noch etwas, das oft übersehen wird: **Souveränität der Metadaten.** Wem gehören die Geschäftsdefinitionen und Klassifizierungen, die ein Agent auf einer Cloud-Plattform verarbeitet? Diese Frage klingt abstrakt. Bis der Anbieter seine API ändert oder seinen Dienst einstellt. Dann wünschst du dir, dass du deine semantische Schicht unter eigener Kontrolle hast. Gerade für europäische Organisationen mit besonderen Anforderungen an die Datenhoheit ist das keine theoretische Überlegung. Es ist eine strategische Entscheidung, die du heute triffst, aber deren Konsequenzen erst in drei Jahren sichtbar werden.
## Fazit
KI-Agenten im Datenmanagement sind kein Hype. Sie werden kommen, und sie werden vieles besser machen. Aber sie werden nichts besser machen für Organisationen, die ihre Daten nicht kennen.
Drei Stufen lassen sich nicht überspringen. Auch nicht mit dem klügsten Agenten.
## Quick Check: Ist deine Organisation bereit für KI-Agenten im Datenmanagement?
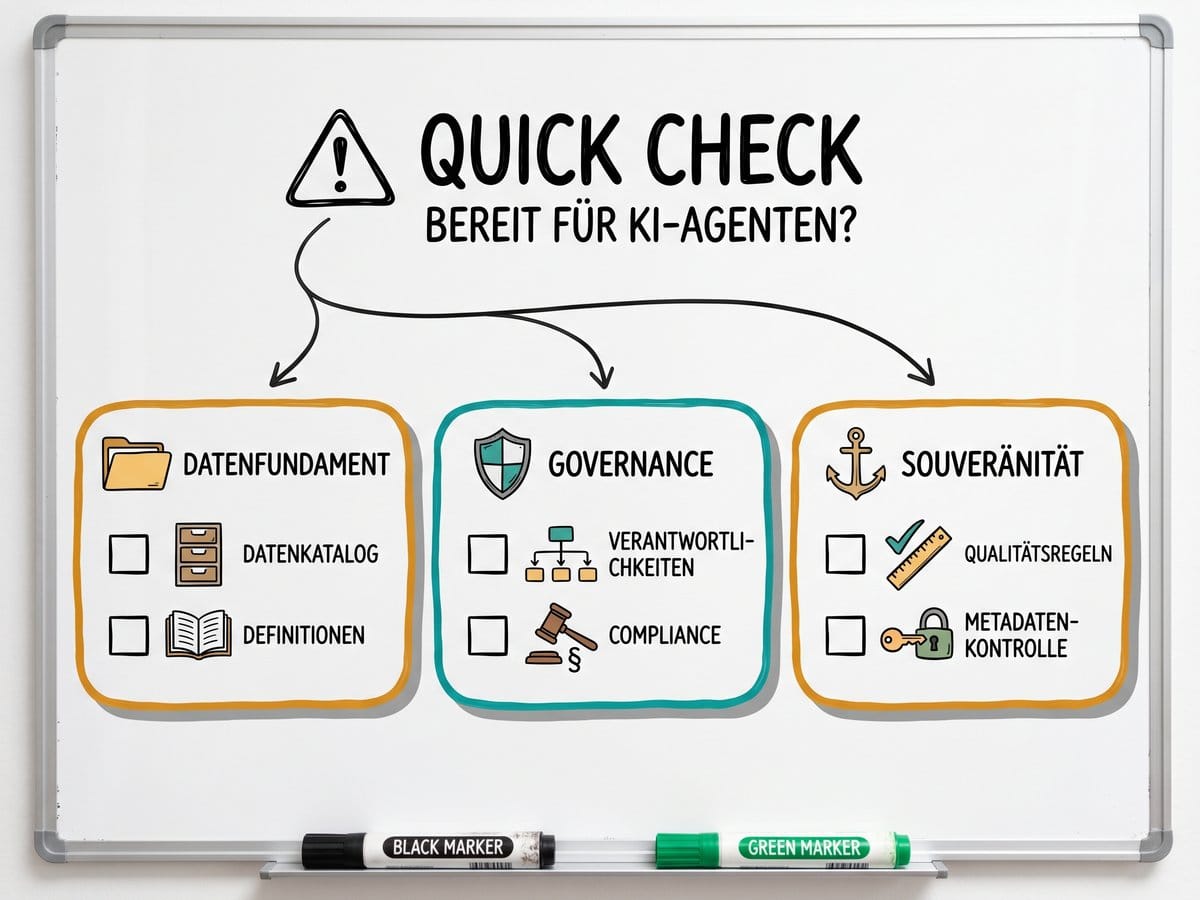
Die folgenden Warnsignale sind keine theoretische Checkliste. Jede rote Flagge deutet darauf hin, dass die Voraussetzungen für agentenbasiertes Datenmanagement noch nicht stehen. Das ist kein Versagen. Es ist die ehrliche Bestandsaufnahme, ohne die kein sinnvoller nächster Schritt möglich ist.
Nimm dir zehn Minuten und geh die Punkte mit deinem Datenteam durch. Wenn mehr als zwei auf deine Organisation zutreffen, ist die Investition in Grundlagen nicht nur sinnvoller als die Investition in Agenten. Sie ist die Voraussetzung dafür, dass die Agenten-Investition später überhaupt Wirkung zeigt.
✅
****Datenkatalog**. Kannst du in weniger als zehn Minuten herausfinden, welche Daten in einem bestimmten System liegen und wer dafür verantwortlich ist? **Ohne aktuellen Datenkatalog fehlt KI-Agenten das Fundament. Sie automatisieren Prozesse auf Daten, deren Bedeutung sie nicht kennen.*
✅
****Geschäftsdefinitionen**. Gibt es maschinenlesbare Definitionen für die wichtigsten Datenobjekte deiner Organisation? **Eine semantische Schicht ist für KI-Agenten nicht optional. Ohne sie können Agenten Beziehungen zwischen Daten nicht verstehen und treffen falsche Entscheidungen.*
✅
****Datenqualitätsregeln**. Existieren dokumentierte Qualitätsregeln, die automatisiert geprüft werden? **Agenten brauchen klare Kriterien. Wenn bisher keine regelbasierte Qualitätsprüfung funktioniert, wird eine agentenbasierte erst recht scheitern.*
✅
****Governance-Verantwortlichkeiten**. Ist für jede Datenklasse klar, wer die fachliche Letztentscheidung bei Klassifizierung und Zugriff trägt? **Autonome Governance-Entscheidungen durch Agenten erfordern definierte Eskalationsstufen. Ohne klare Verantwortlichkeiten entsteht ein Vakuum, das im regulierten Umfeld nicht akzeptabel ist.*
✅
****Compliance-Architektur**. Ist die menschliche Letztentscheidung bei sensiblen Daten als Architekturprinzip verankert, nicht nur als Prozessschritt? **Im Kontext von DSGVO und Geheimschutz reicht eine nachträgliche Kontrolle nicht. Human-in-the-Loop muss systemisch eingeplant sein.*
✅
****Metadaten-Souveränität**. Hast du die Kontrolle über deine Geschäftsdefinitionen und Klassifizierungen, auch wenn du den Plattformanbieter wechselst? **Wer seine semantische Schicht an einen einzelnen Anbieter bindet, verliert im Ernstfall nicht nur ein Tool, sondern das Verständnis seiner eigenen Daten.*
---
Your Data Isn't Ready for AI Agents by Andreas Lezgus
Most organizations want autonomous data management. Almost none have the foundation it requires.
[Read on Substack](https://substack.lezgus.de/p/your-data-isnt-ready-for-ai-agents?ref=lezgus.de)
### Der KI-Arbeitsplatz braucht einen Kompass: Warum Technologie allein nichts ändert
URL: https://www.lezgus.de/der-ki-arbeitsplatz-braucht-einen-kompass-warum-technologie-allein-nichts-andert/
Last updated: 2026-07-05T13:05:36.000Z
Viele IT-Verantwortlichen nennen Sicherheit und Governance als größtes Hindernis für eine organisationsweite KI-Einführung. Gleichzeitig glauben die Mehrzahl der Beschäftigten, dass ihre Organisation sie durch KI ersetzen will. Zwei Zahlen, die dasselbe Problem beschreiben: Organisationen haben vergessen, ihre Beschäftigten auf dem Weg zum KI-Arbeitsplatz mitzunehmen. Und wer seine Leute vergisst, verliert nicht nur deren Vertrauen. Er verliert die gesamte Investition.
## Wo stehen wir wirklich?
Die Ernüchterung kommt nicht überraschend. Wenige der CIOs und IT-Entscheider bewerten den eigenen Fortschritt bei KI-Projekten als gut oder sehr gut. Das bedeutet im Umkehrschluss: Fast zwei Drittel sind mit dem Status quo unzufrieden. Die Pilotprojekte laufen. Die Lizenzen sind gekauft. Die Demos haben beeindruckt. Aber die Breitenwirkung bleibt aus.
Aus der Praxis ist das Muster gut zu erkennen. Wir haben KI-Werkzeuge bereitgestellt, Schulungen organisiert, Use Cases definiert. Trotzdem lag die tägliche Nutzungsrate unter Durchschnitt. Das Problem war nicht die Technik. Das Problem war, dass die Beschäftigten nicht verstanden haben, warum sie KI nutzen sollten, wie es ihnen konkret hilft und ob ihre Arbeitsplätze sicher sind.
Der Fehler liegt im Ansatz. Die meisten KI-Einführungen folgen einem vertrauten Schema: IT beschafft, IT konfiguriert, IT schult. Was fehlt, ist der Mensch als Ausgangspunkt der Strategie. Nicht als Empfänger einer Technologie, sondern als Gestalter der eigenen Arbeitsweise.
## Der Kompass zeigt nach Norden: zum Menschen
Was braucht eine Organisation, die KI nicht nur einführt, sondern tatsächlich nutzt? Einen Kompass, der bei jeder Entscheidung zum Menschen zeigt. Nicht als Floskel auf Foliensatz Seite 3, sondern als operatives Prinzip.
Dieser Kompass hat drei Koordinaten: **Vertrauen aufbauen**, **verantwortungsvoll steuern** und **konsequent befähigen**. Die Reihenfolge ist kein Zufall. Ohne Vertrauen keine Akzeptanz. Ohne klare Regeln keine Sicherheit. Ohne Befähigung keine nachhaltige Nutzung.
Klingt logisch. In der Praxis scheitert es meistens am ersten Punkt.
## Vertrauen: Die unterschätzte Währung
Viele IT-Verantwortlichen sagen, dass der Hauptdruck für KI-Einführung von der Behördenleitung oder Unternehmensleitung kommt. Das ist nicht per se schlecht. Aber nur ein geringer Teil der Beschäftigten fühlen sich in Entscheidungen rund um KI einbezogen. Diese Kluft ist gefährlich.
Wenn Führungskräfte nach außen eine "KI-First"-Strategie kommunizieren und intern gleichzeitig Kostensenkung und Stellenabbau betonen, entsteht kein Vertrauen. Es entsteht Angst. Und Angst ist der zuverlässigste Killer jeder Technologieadoption.
**Drei Dimensionen von Vertrauen** sind dabei entscheidend. Erstens: Vertrauen der Beschäftigten in die Absichten der Organisation. Zweitens: Vertrauen zwischen den Beteiligten innerhalb der Organisation, von IT über Fachabteilungen bis zur Amtsleitung oder Geschäftsführung. Drittens: Vertrauen in die Technologie selbst und ihre Anbieter.
Die dritte Dimension wird in Europa zunehmend zur strategischen Frage. Ein geringer Teil der IT-Verantwortlichen vertrauen darauf, dass Anbieter ihre Produkt-Roadmaps tatsächlich umsetzen. Noch weniger vertrauen auf faire und vorhersehbare Preisgestaltung. Für Organisationen in regulierten Bereichen kommt ein weiteres Problem hinzu: Viele KI-Anbieter können die erforderliche Datenhoheit und regionale Datenverarbeitung schlicht nicht liefern, weil sie in der Entwicklung neuer Funktionen schneller sind als in der Anpassung an europäische Anforderungen.
Was bedeutet das konkret? Organisationen müssen ihre KI-Strategie bewusst selbst gestalten, statt sie vom Angebotsportfolio eines einzelnen Anbieters diktieren zu lassen. Das heißt: regionale Anbieter evaluieren, eine bewusste Multi-Anbieter-Strategie verfolgen und Beschäftigte in Anbieterentscheidungen einbeziehen. Die Frage "Wie passt dieses Werkzeug in meinen Arbeitsalltag?" wiegt schwerer als jede Benchmark auf einer Konferenzfolie.
## Governance: Vom Verhinderer zum Ermöglicher
Die meisten der IT-Verantwortlichen sagen, sie brauchen bessere technische Kontrollen für KI-Governance. Die wenigsten haben das Gefühl, die richtigen internen Governance-Prozesse zu haben. Das ist eine bemerkenswerte Lücke.
Die Reaktion vieler Organisationen ist nachvollziehbar, aber falsch. Viele beschränken KI-Werkzeuge auf sogenannte "vertrauenswürdige Nutzer" oder risikoarme Anwendungsfälle. Das klingt vernünftig. In Wirklichkeit treibt es die Beschäftigten in die Schatten-KI, also in die Nutzung nicht genehmigter Werkzeuge ohne jede Kontrolle. Das Risiko steigt, statt zu sinken.
Besser wäre ein Ansatz, der Governance nicht als Blockade versteht, sondern als Leitplanke. Ein Rahmen, der Innovation ermöglicht und gleichzeitig Risiken handhabbar macht.
### Vier Risiken, die jede Organisation verstehen muss
Die KI-Risikolandschaft hat sich in den letzten Monaten deutlich verändert. Vier Risiken verdienen besondere Aufmerksamkeit.
**Übermäßiges Datenteilen.** KI-Assistenten arbeiten mit den Daten, auf die sie Zugriff haben. Wenn die Berechtigungsstrukturen nicht stimmen, zeigen sie sensible Informationen Beschäftigten, die keinen Zugang haben sollten. Das ist kein hypothetisches Szenario. Eingebettete KI-Assistenten greifen auf veraltete Projektdokumentation zu und liefern Ergebnisse , die auf längst überholten Informationen basierten. Niemand prüft die Zugriffsrechte.
**Neue Angriffsvektoren.** KI-Werkzeuge und Agenten können durch Techniken wie Prompt Injection oder Data Poisoning kompromittiert werden. Besonders relevant ist das für Anwendungen, die nach außen exponiert sind, etwa auf Webseiten oder in E-Mail-Systemen.
**Agenten-Wildwuchs.** Jeder Anbieter baut gerade KI-Agenten in seine Produkte ein. Wenn zu viele Agenten mit zu vielen Berechtigungen entstehen und unkontrolliert geteilt werden, explodieren nicht nur die Risiken, sondern auch die Kosten.
**KI-Schlacke.** Große Mengen maschinell erzeugter Inhalte, die professionell aussehen, aber substanzlos sind. Sie überschwemmen interne Kanäle, untergraben Vertrauen und führen dazu, dass Beschäftigte mehr Zeit mit dem Korrigieren schlechter KI-Ergebnisse verbringen als mit produktiver Arbeit.
Das eigentliche Problem: Neue Risiken türmen sich auf, bevor die bestehenden gelöst sind. Das erzeugt bei Sicherheits- und IT-Teams das Gefühl, KI-Initiativen lieber blockieren zu müssen.
### Adaptive Governance statt Einheitsbrei
Die Lösung liegt nicht in mehr Verboten, sondern in abgestufter Kontrolle. Ein KI-Agent, der nur lesend auf eine einzige interne Datenquelle zugreift und mit wenigen Personen geteilt wird, braucht andere Regeln als ein Agent, der schreibend auf mehrere Systeme zugreift und der gesamten Organisation zur Verfügung steht.
Aus meiner Erfahrung in der Praxis funktioniert das so: Jeder Agent wird bei seiner Erstellung mit einem Risikoprofil versehen. Niedrigrisiko-Agenten können von Fachabteilungen eigenständig erstellt werden. Hochrisiko-Agenten durchlaufen einen Freigabeprozess. Entscheidend ist dabei ein zentrales Inventar aller Agenten, gekoppelt mit kontinuierlichem Monitoring. Du kannst nicht steuern, was du nicht siehst.
Vier Kontrollpunkte haben sich als Praxis bewährt: ein zentrales KI-Inventar für Transparenz, ein Identitätsmanagement für Agenten, eine Informations-Governance für Datenzugriffe und ein Monitoring für Verhaltensänderungen. Kein einzelner Anbieter deckt alle vier Punkte ab. Aber wer sie als Rahmen versteht, hat eine belastbare Governance-Architektur.
## Befähigung: Vom Schulungsprogramm zur KI-Fitness
Vertrauen und Governance schaffen den Rahmen. Aber ohne aktive Befähigung bleibt KI ein Werkzeug, das im Schrank liegt. Eine Vielzahl an Beschäftigten glauben, dass KI ihren Arbeitsplatz in den nächsten fünf Jahren ersetzen könnte. Solange diese Angst nicht adressiert wird, bleibt jede Schulung wirkungslos.
Die meisten Organisationen setzen auf generische Einmalschulungen. Die Nutzung steigt kurz nach der Schulung an und fällt dann sofort wieder ab. Das Muster ist vorhersehbar, weil es den Kern des Problems ignoriert: KI ist die individuellste Technologie, die IT-Abteilungen jemals eingeführt haben. Jeder Beschäftigte nutzt sie anders, abhängig von Rolle, Kompetenz und Aufgaben.
Was stattdessen funktioniert, sind drei kulturelle Grundpfeiler.
**Sicherheit zum Scheitern.** Beschäftigte brauchen die Freiheit, mit KI zu experimentieren, ohne Konsequenzen zu fürchten. Das bedeutet auch: KI nicht als "digitalen Kollegen" oder "digitalen Mitarbeiter" bezeichnen. Diese Vermenschlichung löst Identitätskonflikte aus und verstärkt die Angst vor Ersetzung. KI ist ein Werkzeug. Ein mächtiges, aber eben ein Werkzeug.
**Vorbildfunktion der Führung.** Wenn die Führungsebene selbst keine KI nutzt oder widersprüchliche Signale sendet, folgt niemand. Führungskräfte müssen nicht nur über KI reden, sondern sie sichtbar einsetzen und den Nutzen für die eigene Arbeit kommunizieren.
**Anreize statt Pflicht.** KI-Nutzung zu verordnen erzeugt Minimalverhalten. Besser: Zeit für Experimente schützen, Erfolge sichtbar machen, Wissen teilen belohnen. Ein Gamification-Ansatz, bei dem Beschäftigte für absolvierte KI-Lernmodule Punkte sammeln, die sie gegen Belohnungen eintauschen können, hat in Praxisbeispielen zu einer erheblichen KI-Nutzung innerhalb eines Quartals geführt.
Besonders wirksam sind **KI-Praxisgemeinschaften oder KI-Days**, die sich nicht um abstrakte Technik drehen, sondern um konkrete Arbeitsprobleme. Welche Aufgabe dauert zu lang? Welcher Prozess ist zu aufwendig? Welche Routinearbeit frisst Zeit, die für Wichtigeres fehlt? Wenn KI-Lernen an reale Arbeitsprobleme gekoppelt wird, verdoppelt sich die Adoptionsrate im Vergleich zu unstrukturiertem Experimentieren.
## Die Zusammenarbeit der Teams ist der Schlüssel
Ein Aspekt wird in fast jeder KI-Strategie unterschätzt: Die nötigen Kompetenzen liegen in verschiedenen Teams. Die IT-Sicherheit versteht die Risiken. Die Rechtsabteilung kennt die regulatorischen Anforderungen. Die Digital-Workplace-Teams wissen, was die Beschäftigten brauchen. Aber diese Teams arbeiten selten zusammen.
Wichtig ist daher diese Silos aufzubrechen. Sicherheit, Compliance, Digital Workplace und Identitätsmanagement sind durch gemeinsam KI-Richtlinien zu verbinden. Das Ergebnis: Richtlinien, die von allen Seiten getragen werden und die mit einer Stimme kommunizieren werden können. Die Beschäftigten wissen zum ersten Mal genau, was erlaubt ist, was nicht und warum. Das erledigt mehr für die KI-Adoption als jede Schulung.
Die wenigsten Organisationen haben diese Abstimmung zwischen Beschäftigten, IT und Führung erreicht. Aber diejenigen, die es geschafft haben, berichten über extrem höheren Nutzen aus ihren KI-Werkzeugen. Die Zahlen sind eindeutig.
## Der Weg nach vorn
Der KI-native Arbeitsplatz ist kein Zustand, den man einmal erreicht und dann hält. Er ist ein fortlaufender Anpassungsprozess, in dem Menschen und KI-Werkzeuge zusammenarbeiten, und zwar bewusst gestaltet, nicht zufällig.
Fang nicht bei der Technologie an. Fang beim Vertrauen an. Räum die Governance-Silos auf. Und dann befähige deine Leute so, dass sie KI nicht fürchten, sondern als Werkzeug beherrschen.
Der härteste Teil ist nicht die Technik. Der härteste Teil ist, seinen eigenen Leuten zuzuhören, bevor man ihnen ein neues Werkzeug in die Hand drückt. Wer das schafft, braucht keinen Kompass mehr. Der hat die Richtung verstanden.
## Quick Check: Ist deine Organisation bereit für den KI-Arbeitsplatz?
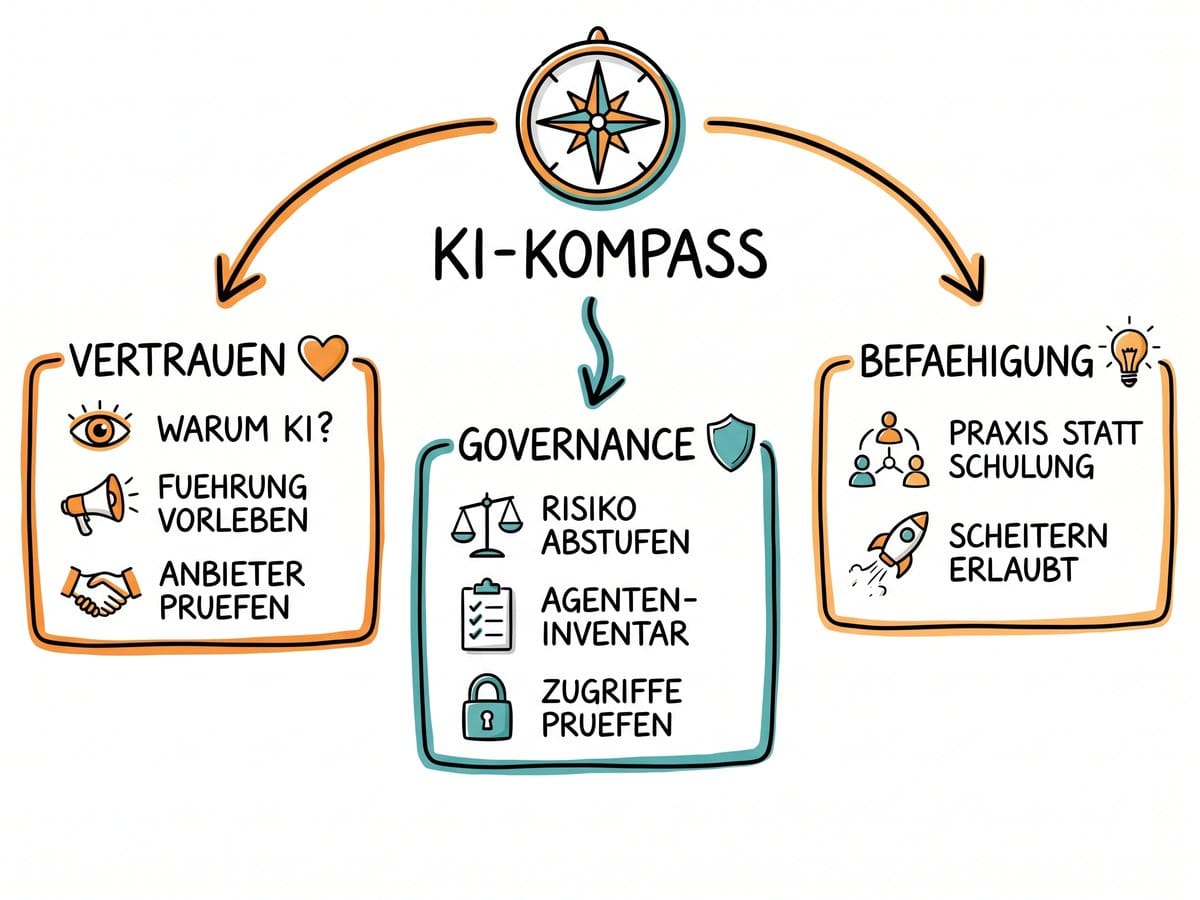
Checkliste für den KI-Kompass
✅
****Vertrauenslücke**. Prüffrage: Wissen deine Beschäftigten, warum KI eingeführt wird, und fühlen sie sich einbezogen? **Ohne Transparenz entsteht Angst, die jede Adoption blockiert.*
✅
****Führungssignale**. Prüffrage: Nutzen deine Führungskräfte KI selbst sichtbar und kommunizieren sie konsistent? **Widersprüchliche Botschaften zwischen externer Positionierung und interner Kommunikation zerstören Vertrauen.*
✅
****Governance-Modell**. Prüffrage: Hast du ein abgestuftes Risikosystem für KI-Werkzeuge und Agenten statt einer Entweder-oder-Entscheidung? **Pauschale Verbote treiben Beschäftigte in die Schatten-KI.*
✅
****Agenten-Inventar**. Prüffrage: Existiert ein zentrales Verzeichnis aller KI-Agenten mit Risikobewertung und Monitoring? **Du kannst nicht steuern, was du nicht siehst.*
✅
****Datenberechtigungen**. Prüffrage: Sind die Zugriffsrechte für KI-Werkzeuge geprüft und auf dem aktuellen Stand? **Veraltete Berechtigungen führen zu unkontrolliertem Datenteilen.*
✅
****Befähigungsansatz**. Prüffrage: Bietet deine Organisation rollenspezifische KI-Praxis statt generischer Einmalschulungen? **Generische Schulungen erzeugen kurzfristige Nutzungsspitzen, aber keinen nachhaltigen Kompetenzaufbau.*
✅
****Anbieter-Souveränität**. Prüffrage: Bestimmst du deine KI-Strategie selbst oder lässt du sie vom Angebotsportfolio eines Anbieters diktieren? **Herstellerabhängigkeit gefährdet die Handlungsfähigkeit und treibt Kosten.*
---
### KI-Governance ist Teamsport: Warum der AI Act nur eine Grundlage ist
URL: https://www.lezgus.de/ki-governance-ist-teamsport-warum-der-ai-act-allein-nichts-andert/
Last updated: 2026-05-16T19:51:45.000Z
Neun verschiedene Bias-Arten können ein einziges KI-System gleichzeitig verzerren. Neun. Nicht zwei oder drei, die sich mit einem schnellen Patch beheben lassen, sondern neun systematische Fehlerquellen, die von der Datenerhebung über das Training bis zur Ausgabe an den Endnutzer wirken. Und die vier gängigen Fairness-Metriken, mit denen man diese Verzerrungen messen kann, schließen sich teilweise gegenseitig aus. Wer also glaubt, KI-Governance sei ein Compliance-Formular mit ein paar Häkchen, hat das Problem nicht verstanden. Warum behandeln so viele Organisationen KI-Governance trotzdem als reines IT-Projekt?
## Warum der AI Act notwendig ist, aber nicht reicht
Der EU AI Act setzt einen regulatorischen Rahmen, der überfällig war. Risikobasierte Klassifizierung, Pflicht zur KI-Literacy, ethische Nutzungsrichtlinien, schrittweise Umsetzung mit Pilotprojekten. Das ist das Fundament. Kein vernünftiger Mensch wird dagegen argumentieren.
**Aber ein Fundament ist kein Haus.**
In einem großen Behördenumfeld habe ich erlebt, wie eine Organisation den AI Act pflichtbewusst umsetzte. Risikoklassen definiert, Dokumentation erstellt, Schulungsplan aufgesetzt. Auf dem Papier war alles compliant. In der Praxis fehlte ein funktionierendes Governance-Modell, das die Frage beantwortete: Wer entscheidet eigentlich was, wenn ein KI-System in Betrieb geht? Die IT-Abteilung verwies auf die Fachabteilung. Die Fachabteilung verwies auf den Datenschutzbeauftragten. Der Datenschutzbeauftragte verwies auf die Rechtsabteilung. Die Rechtsabteilung wartete auf Präzedenzfälle.
**Das Ergebnis war eine Governance-Lähmung bei vollständiger regulatorischer Compliance.**
Der AI Act fordert eine frühzeitige Risiko- und Impact-Analyse. Er fordert KI-Literacy. Er fordert ethische Nutzungsrichtlinien. Was er nicht liefert, ist die organisatorische Architektur, die diese Anforderungen in gelebte Praxis übersetzt. Diese Architektur muss jede Organisation selbst bauen. Und genau hier beginnt der eigentliche Teamsport.
## Sechs Pfeiler, ohne die nichts funktioniert
Wirksame KI-Governance ruht auf sechs Pfeilern, die sich gegenseitig bedingen. Keiner davon ist optional, und keiner funktioniert isoliert.
**Verantwortlichkeit** steht an erster Stelle. Nicht als abstraktes Prinzip, sondern als benannte Zuständigkeit. Wer ist verantwortlich für das Risiko eines spezifischen KI-Systems? Wer genehmigt den Einsatz? Wer zieht die Reißleine, wenn etwas schiefläuft? In vielen Organisationen bleibt diese Frage bewusst offen, weil eine klare Antwort auch klare Konsequenzen nach sich zöge.
**Policy** als zweiter Pfeiler meint nicht das hundertste Strategiepapier, das in der Schublade verschwindet. Gemeint ist ein operativ wirksames Regelwerk, das in den Arbeitsalltag eingreift. Das den Entwickler genauso bindet wie die Führungskraft, die ein KI-Projekt in Auftrag gibt. Eine Policy, die niemand liest, ist schlimmer als keine Policy, denn sie erzeugt eine falsche Sicherheit.
Der dritte Pfeiler ist **Risikomanagement**. KI-Systeme erzeugen spezifische Risiken, die sich von klassischen IT-Risiken unterscheiden. Halluzinationen bei großen Sprachmodellen, Memorisierung personenbezogener Daten, systematische Verzerrungen in Entscheidungsunterstützungssystemen. Diese Risiken erfordern spezifische Bewertungsmethoden und regelmäßige Überprüfung. Nicht einmal im Jahr, nicht bei der Einführung, sondern kontinuierlich während des gesamten Lebenszyklus.
**Datenqualität** als vierter Pfeiler wird oft unterschätzt, obwohl sie über Erfolg und Misserfolg entscheidet. Ohne saubere Daten ist jede KI nur ein blindes Huhn auf der Suche nach Körnern. Datenquellen müssen identifiziert, validiert und regelmäßig geprüft werden. Die Frage, ob Daten in Echtzeit oder als Batch an ein KI-System geliefert werden, ist keine technische Nebensächlichkeit. Sie bestimmt die Qualität der Ergebnisse und damit die Belastbarkeit jeder darauf aufbauenden Entscheidung. Knowledge Graphen und strukturierte Metadaten liefern den Kontext, ohne den Rohdaten oft wertlos sind. Data Lineage, also die Nachvollziehbarkeit des Weges von der Quelle bis zur Verwendung, ist kein Luxus, sondern Grundvoraussetzung für Vertrauen.
Der fünfte Pfeiler betrifft die **Entwicklung**. Wer KI-Systeme entwickelt oder entwickeln lässt, braucht Standards für den gesamten Prozess. Von der Anforderungsanalyse über das Training bis zum Testing. Das gilt besonders für die drei Interventionsphasen gegen Bias: Prä-Prozessierung der Trainingsdaten, In-Prozessierung während des Modelltrainings und Post-Prozessierung bei der Ergebnisausgabe. Jede Phase hat eigene Werkzeuge, eigene Limitationen, eigene Verantwortliche.
Der sechste Pfeiler ist **Deployment und Betrieb**. Ein KI-System, das im Labor funktioniert, kann im Produktivbetrieb völlig andere Ergebnisse liefern. Monitoring, Feedback-Schleifen, definierte Eskalationspfade und geplante Modellaktualisierungen gehören zum Betrieb wie das Ölwechseln zum Autofahren. Wer das vergisst, fährt irgendwann mit Motorschaden auf dem Seitenstreifen.
## Das Drei-Stufen-Rollenmodell: Wer macht was
Alle sechs Pfeiler zusammen ergeben nichts, wenn die Verantwortlichkeiten nicht geklärt sind. Ein dreistufiges Rollenmodell hat sich in der Praxis bewährt.
Die **Owner-Rolle** trägt die Gesamtverantwortung für ein KI-System oder einen KI-Einsatzbereich. Das ist nicht die IT-Leitung. Das ist die Fachverantwortung, die den Nutzen definiert und die Risiken trägt. In Behörden bedeutet das: Die Abteilungsleitung, die KI für ihre Fachprozesse einsetzt, ist auch dafür verantwortlich, dass der Einsatz regelkonform und wirksam erfolgt.
Die **Partner-Rolle** umfasst alle Bereiche, die zur Governance beitragen, ohne selbst die Gesamtverantwortung zu tragen. Datenschutz, IT-Sicherheit, Recht, Personalvertretung, Qualitätsmanagement. Diese Bereiche liefern Expertise, Bewertungen und Freigaben. Sie haben ein Vetorecht bei kritischen Fragen, aber sie sind nicht der Engpass für jede operative Entscheidung.
Die **Support-Rolle** stellt Ressourcen bereit. Infrastruktur, Schulungen, Werkzeuge, Dokumentation. Ohne funktionierenden Support bleiben Owner und Partner handlungsunfähig.
In meiner langjährigen Praxis in hochregulierten Organisationen habe ich eines gelernt: Dieses Modell funktioniert nur, wenn die Rollen explizit zugewiesen und kommuniziert werden. Implizite Rollenverteilung führt zu dem Phänomen, das ich oben beschrieben habe. Alle sind irgendwie zuständig, also niemand wirklich.
## Warum Du einen AI Lenkungsausschuss brauchst
Ein Governance-Modell mit klaren Rollen braucht ein Koordinierungsgremium. Das AI Lenkungsgremium ist dieses Gremium. Nicht als weiteres Debattierklub-Format, sondern als Entscheidungsorgan mit echten Befugnissen.
Ein formelles Charter-Dokument legt die Prinzipien, Verantwortlichkeiten und Entscheidungsprozesse fest. Klingt bürokratisch? Ist es auch. Aber ohne diese Formalisierung passiert eines von zwei Dingen: Entweder entscheidet niemand, oder jemand entscheidet ohne Mandat. Beides endet schlecht.
Die Besetzung ist der kritischste Erfolgsfaktor. Ein AI Lenkungsausschuss, der nur aus IT-Experten besteht, wird technisch brillante Entscheidungen treffen, die an der organisatorischen Realität scheitern. Ein Lenkungsausschuss ohne technische Expertise wird Risiken unterschätzen oder Chancen verpassen. Interdisziplinarität ist hier kein Modewort, sondern eine funktionale Notwendigkeit. Recht, Datenschutz, Fachbereiche, IT, Personalvertretung und Führungsebene gehören an denselben Tisch.
Externe Standards wie die des National Institute of Standards and Technology, das BSI Grundschutz Kompendium oder der International Organization for Standardization stärken die Governance, weil sie einen Referenzrahmen bieten, der über die eigene Organisation hinausgeht. Wer ausschließlich interne Maßstäbe anlegt, läuft Gefahr, blinde Flecken zu institutionalisieren.
Die größte Gefahr eines AI Lenkungsausschusses liegt allerdings in der Übersteuerung. Wenn jede KI-Anwendung durch ein mehrstufiges Genehmigungsverfahren muss, entsteht ein Flaschenhals, der Innovation erstickt. Die Kunst liegt in der Abstufung: Hochrisiko-Anwendungen erfordern volle Committee-Bewertung, Standard-Anwendungen durchlaufen einen vereinfachten Prozess, und für Experimente im Sandkasten reicht eine Anzeigepflicht.
Nach meiner Erfahrung aus mehreren KI-Piloten im öffentlichen Sektor braucht ein AI Lenkungsausschuss vier Dinge: ein klares Mandat, eine handhabbare Sitzungsfrequenz (monatlich reicht in den meisten Fällen), einen schlanken Eskalationspfad für dringende Fälle und die Bereitschaft, Entscheidungen tatsächlich zu treffen. Das klingt selbstverständlich. Die Praxis zeigt, dass es das nicht ist.
## Der blinde Fleck: Drittanbieter-Management
Viele Organisationen bauen KI-Systeme nicht selbst, sondern kaufen sie ein oder nutzen Cloud-Dienste. Das verlagert die technische Verantwortung, aber nicht die Governance-Verantwortung.
Drittanbieter-Management ist der am häufigsten vernachlässigte Aspekt der KI-Governance. Welche Daten fließen an den Anbieter? Wo werden Modelle trainiert und betrieben? Welche Transparenzpflichten hat der Anbieter? Was passiert, wenn der Anbieter sein Modell ändert und sich dadurch die Ergebnisqualität verschiebt?
Besonders bei großen Sprachmodellen stellt sich die Frage der Verantwortungsdifferenzierung mit Schärfe. Die Verantwortlichkeiten zwischen Entwickler, Betreiber und Nutzer müssen klar getrennt werden. Der Entwickler verantwortet die Modellarchitektur und die Trainingsdaten. Der Betreiber verantwortet die Integration und die Absicherung gegen Missbrauch. Der Nutzer verantwortet die sachgemäße Anwendung und die Bewertung der Ergebnisse.
In der Praxis verwischt diese Dreiteilung. Wer einen Cloud-basierten KI-Dienst nutzt, ist gleichzeitig Nutzer und teilweise Betreiber. Der Black-Box-Charakter vieler KI-Systeme erschwert die Wahrnehmung von Betroffenenrechten. Wenn ein Betroffener Auskunft verlangt, welche seiner Daten ein LLM verarbeitet hat, kann der Betreiber diese Frage oft nicht beantworten. Das ist kein theoretisches Problem, sondern ein datenschutzrechtlicher Dauerbrenner.
## Sicherheitsbehörden und der Sonderweg
Für Organisationen im Sicherheitsbereich kommt eine zusätzliche Dimension hinzu. Der EU AI Act nimmt Verteidigungsanwendungen explizit aus. Das bedeutet nicht, dass keine Governance nötig ist. Es bedeutet, dass eine eigene Governance-Verantwortung entsteht, die nicht auf externe Regulierung warten kann.
Drei Stakeholder-Ebenen spielen hier zusammen: die strategische Ebene, die den politischen Rahmen setzt, die operative Ebene, die KI-Systeme in Prozesse integriert, und die taktische Ebene, die mit den Ergebnissen arbeitet. Jede Ebene hat eigene Anforderungen an Vertrauenswürdigkeit und Nachvollziehbarkeit.
Die Prinzipien der Verantwortlichkeit, Transparenz und Fairness gelten auch hier. Doch sie geraten in Konflikt mit den Anforderungen der Geheimhaltung. Wie transparent kann ein KI-System sein, das in einem klassifizierten Umfeld eingesetzt wird? Wie nachvollziehbar dürfen Entscheidungswege sein, wenn die zugrunde liegenden Daten nicht offengelegt werden können?
Eine einfache Antwort existiert nicht. Aber ein praktikabler Ansatz schon: Vertrauenswürdigkeit wird in diesen Kontexten nicht durch öffentliche Transparenz hergestellt, sondern durch institutionelle Kontrolle. Unabhängige interne Prüfinstanzen, abgestufte Zugriffsrechte auf Modellbewertungen und eine dokumentierte Entscheidungshistorie, die im Bedarfsfall von autorisierten Stellen eingesehen werden kann. Das ist mühsam. Es funktioniert.
## Der Faktor Mensch: Schulung und Kommunikation
Governance-Strukturen bleiben wirkungslos, wenn die Beteiligten sie nicht verstehen oder nicht unterstützen. Die Erfahrung aus über vier Jahrzehnten in der öffentlichen Verwaltung hat mich eines gelehrt: Die schönste Organisationsanweisung ist nichts wert, wenn sie nicht kommuniziert und geschult wird. Und zwar nicht in einer Rundmail mit Anlage.
KI-Literacy ist eine Pflicht, die der AI Act zurecht einfordert. Aber Literacy allein genügt nicht. Wer versteht, was ein KI-System tut, versteht noch nicht, welche Rolle er in der Governance dieses Systems spielt. Ein Kommunikationsplan muss die Governance-Rollen, Prozesse und Eskalationswege so vermitteln, dass jeder Beteiligte weiß, was er zu tun hat und warum.
Schulungen müssen zielgruppenspezifisch sein. Eine Führungskraft braucht keine Erklärung von Backpropagation, aber sie muss verstehen, warum ein KI-System diskriminieren kann und welche Fragen sie stellen muss, bevor sie eine Freigabe erteilt. Ein Fachanwender braucht keine Governance-Theorie, aber er muss wissen, wann ein Ergebnis plausibel ist und wann er eskalieren sollte. Die IT braucht beides.
## Vom Papier zur Praxis: Umsetzungsempfehlungen
Wie überführst Du diese Analyse in Deine Organisation? Nicht mit einem Jahrhundertprojekt, sondern mit vier konkreten Schritten, die Du morgen beginnen kannst.
**Erstens: Bestandsaufnahme der KI-Systeme.** Klingt banal, ist es nicht. In vielen Organisationen weiß niemand vollständig, welche KI-Systeme im Einsatz sind. Cloud-basierte Übersetzungsdienste, KI-gestützte Suchfunktionen in Fachverfahren, automatisierte Textvorschläge in E-Mail-Programmen. All das sind KI-Systeme, die unter die Governance fallen. Ohne Inventar keine Governance.
**Zweitens: Governance-Rollen zuweisen.** Für jedes identifizierte KI-System oder jeden Einsatzbereich wird ein Owner benannt. Nicht die IT-Abteilung als Sammelzuständigkeit, sondern die Fachverantwortung, die den Nutzen verantwortet. Dann werden Partner und Support-Rollen zugeordnet. Das geht in einer einzigen Sitzung pro Einsatzbereich.
**Drittens: AI Committee aufsetzen.** Das Charter-Dokument muss keine hundert Seiten haben. Mandat, Besetzung, Sitzungsrhythmus, Entscheidungsbefugnisse, Eskalationspfad. Zwei bis drei Seiten reichen. Die erste Sitzung sollte innerhalb von vier Wochen stattfinden, nicht nach einem halben Jahr Vorbereitung.
**Viertens: Data-Readiness-Check durchführen.** Für jedes KI-System die Datenquellen identifizieren, Qualität bewerten, Lineage dokumentieren. Das ist aufwendig, aber ohne saubere Datenbasis baut jedes KI-Projekt auf Sand. Und auf Sand baut man keine tragfähige Governance.
Jeder dieser Schritte ist reversibel. Keiner erfordert ein Millionenbudget. Alle erfordern den Willen, KI-Governance nicht als IT-Thema zu delegieren, sondern als organisationsübergreifende Führungsaufgabe zu begreifen.
## Der Appell
KI-Governance ist kein Häkchen auf einer Compliance-Checkliste. Sie ist eine Führungsaufgabe, die Disziplinen verbindet, Verantwortung zuweist und Strukturen schafft, die über den nächsten Audit-Termin hinaus Bestand haben. Der AI Act gibt Dir den regulatorischen Rahmen. Das Governance-Modell musst Du selbst bauen.
Fang an. Nicht mit dem perfekten Framework, sondern mit der ehrlichen Frage: Wer in Deiner Organisation entscheidet gerade über KI, und auf welcher Grundlage? Wenn die Antwort länger als zwei Sätze dauert, hast Du Dein erstes Governance-Problem gefunden.
Die Schule des Lebens kennt keine Ferien. KI-Governance leider auch nicht.
## Quick Check: Ist Deine KI-Governance belastbar?
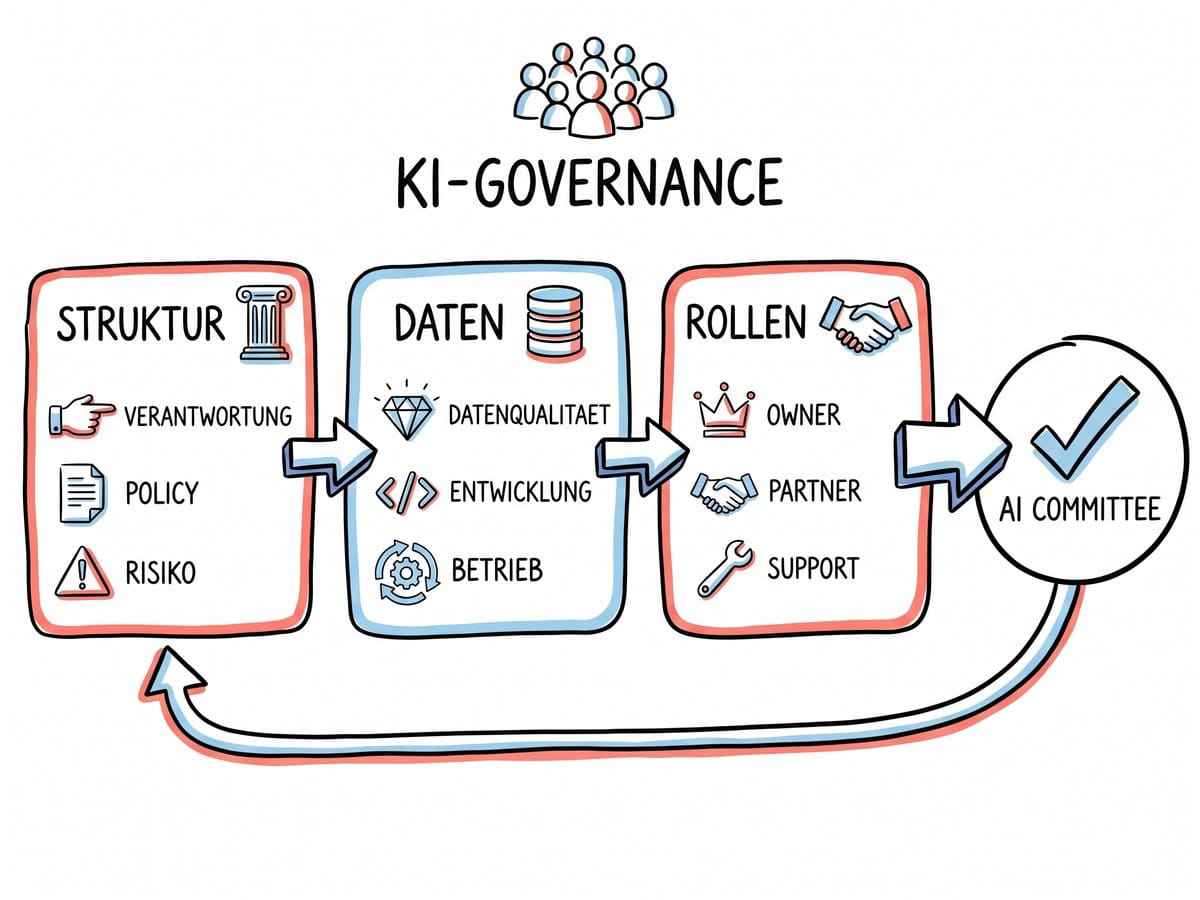
✅
****KI-Inventar**. Prüffrage: Kennst du alle KI-Systeme, die in deiner Organisation im Einsatz sind, einschließlich Cloud-Dienste und eingebetteter Funktionen? **Ohne vollständiges Inventar gibt es keine systematische Governance, nur Stückwerk.*
✅
****Rollenklarheit.** Prüffrage: Ist für jedes KI-System ein Owner benannt, der die Fach- und Governance-Verantwortung trägt? **Implizite Zuständigkeiten führen zu Governance-Lähmung bei gleichzeitiger formaler Compliance.*
✅
****AI-Gremium**. Prüffrage: Existiert ein interdisziplinäres Gremium mit echtem Entscheidungsmandat für KI-Governance-Fragen? **Ohne Koordinierungsgremium entstehen Siloentscheidungen, die sich gegenseitig widersprechen.*
✅
****Datenqualität**. Prüffrage: Werden Datenquellen für KI-Systeme regelmäßig validiert und ist die Data Lineage dokumentiert? **Ohne saubere Daten und nachvollziehbare Herkunft produziert jedes KI-System unzuverlässige Ergebnisse*.
✅
****Drittanbieter**. Prüffrage: Sind Verantwortlichkeiten zwischen Entwickler, Betreiber und Nutzer bei eingekauften KI-Systemen vertraglich geregelt? **Die häufigste Governance-Lücke liegt bei zugekauften Systemen, nicht bei Eigenentwicklungen.*
✅
****Bias-Prüfung**. Prüffrage: Gibt es definierte Interventionsphasen und Fairness-Metriken für KI-Systeme, die Entscheidungen beeinflussen? **Neun verschiedene Bias-Arten können ein einzelnes System verzerren, ohne dass es im Regelbetrieb auffällt.*
✅
****Schulungskonzept**. Prüffrage: Gibt es zielgruppenspezifische Schulungen, die nicht nur KI-Literacy, sondern auch Governance-Rollen vermitteln? **Wer seine Rolle in der Governance nicht kennt, kann sie nicht ausfüllen, egal wie gut die Strukturen sind.*
---
### Agentic AI: Drei irreversible Veränderungen, auf die sich Führungskräfte jetzt vorbereiten müssen
URL: https://www.lezgus.de/agentic-ai-drei-irreversible-veranderungen-auf-die-sich-fuhrungskrafte-jetzt-vorbereiten-mussen/
Last updated: 2026-07-05T13:07:40.000Z
Du sitzt im Lenkungsausschuss. Die Folie zeigt eine Roadmap für KI-gestützte Prozessautomatisierung, sauber in Quartal 3 und Quartal 4 aufgeteilt. Der Berater spricht von Effizienzgewinnen, von Skalierung, von einem „Piloten mit Potenzial“. Die Köpfe nicken. Dann kommt die Folie mit dem Betriebsmodell: Agenten, die eigenständig Workflows steuern, Daten beschaffen, Ergebnisse bewerten und Entscheidungen vorbereiten. Ohne menschliches Zutun zwischen Auftrag und Ergebnis.
Und niemand fragt: Was passiert mit den 340 Beschäftigten, die genau diese Aufgaben heute erledigen?
Agentic AI ist kein Upgrade bestehender Chatbots. Es ist kein besseres Sprachmodell mit hübscherer Oberfläche. Es ist eine Architektur, in der KI-Systeme eigenständig planen, Werkzeuge einsetzen, reflektieren und ihre Vorgehensweise anpassen. Das klingt nach Science-Fiction. Ist es nicht. Große Finanzdienstleister automatisieren bereits ihre Kreditprüfung mit autonomen Agenten. Konsumgüterhersteller lassen Marketing-Kampagnen von KI-Systemen orchestrieren, die selbständig Datenquellen anzapfen, Zielgruppen segmentieren und Budgets umschichten.
Die Veränderung, die hier stattfindet, ist nicht inkrementell. Sie ist strukturell und in weiten Teilen irreversibel. Drei Effekte treiben diese Entwicklung, und jeder einzelne verdient einen genaueren Blick.
## Wenn der Workflow sich selbst organisiert
Die erste Veränderung betrifft die Art, wie Arbeit organisiert wird. Bisher folgen Geschäftsprozesse einem Muster: Menschen definieren Abläufe, Menschen führen sie aus, Menschen passen sie an, wenn sich Rahmenbedingungen ändern. Agentic AI dreht diese Logik um. Ein Agent erhält ein Ziel, zerlegt es in Teilaufgaben, wählt die passenden Werkzeuge, arbeitet die Schritte ab und korrigiert sich, wenn ein Zwischenergebnis nicht dem erwarteten Muster entspricht.
Das ist kein theoretisches Konstrukt. In der Praxis bedeutet es: Der Agent durchsucht eine Datenbank, bewertet die Ergebnisse gegen definierte Kriterien, ruft bei Bedarf eine zweite Quelle ab und erstellt einen Bericht. Alles in Echtzeit. Alles dynamisch anpassend. Ohne dass ein Mensch die einzelnen Schritte freigeben muss.
Für Führungskräfte ändert sich damit eine Grundannahme. Du steuerst nicht mehr den Prozess. Du steuerst die Zieldefinition und die Leitplanken. Das ist ein fundamentaler Unterschied. Wer bisher über Stellenpläne und Zuständigkeitsmatrix geführt hat, braucht plötzlich ein anderes Instrumentarium. Die Frage ist nicht mehr: Wer macht was? Die Frage lautet: Welche Ergebnisse erwarte ich, und welche Grenzen setze ich?
In hochregulierten Umgebungen, ist das eine besonders heikle Situation. Denn Governance bedeutet hier nicht nur Compliance-Formulare. Es bedeutet: nachvollziehbare Entscheidungsketten, revisionssichere Dokumentation, klare Verantwortlichkeiten. Ein Agent, der sich seinen Weg selbst sucht, muss diese Anforderungen genauso erfüllen wie ein Sachbearbeiter im vierten Stock. Tut er das nicht, entsteht kein Effizienzgewinn. Es entsteht ein rechtliches Risiko und Haftungsrisiko.
Technisch basieren diese Agenten auf einem Zusammenspiel dreier Fähigkeiten: Planung, Werkzeugeinsatz und Reflexion. Der Agent plant seinen Lösungsweg, nutzt verfügbare Datenquellen und Schnittstellen, und bewertet sein eigenes Ergebnis gegen das ursprüngliche Ziel. Wenn das Ergebnis nicht passt, plant er um. Das klingt nach einem erfahrenen Projektleiter. Der Unterschied: Der Agent tut das in Sekunden, nicht in Wochen. Und er wird nie müde, nie frustriert, nie politisch. Ob das ein Vorteil ist, hängt vom Kontext ab.
## Die neue digitale Belegschaft
Die zweite Veränderung ist unangenehmer. Agentic AI schafft eine digitale Belegschaft. Nicht als Metapher. Als operative Realität.
Ein Agent ist zielorientiert. Er bekommt eine Aufgabe, verfolgt sie bis zum Abschluss, meldet das Ergebnis zurück. Mehrere Agenten können koordiniert zusammenarbeiten, sich Teilaufgaben zuweisen, Ergebnisse konsolidieren. Das erinnert nicht zufällig an ein Team. Es funktioniert wie eines.
Die Frage, die Führungskräfte sich stellen müssen, ist unbequem: Wenn ein System mit drei koordinierten Agenten die gleiche Recherche-Aufgabe in 20 Minuten erledigt, für die ein Team aus vier Personen bisher zwei Wochen braucht, was folgt daraus? Nicht die Frage ob, sondern die Frage wann wird diese Leistungsfähigkeit in der Organisation ankommen.
Hier kann ein Denkfehler gefährlich werden. Man plant Agentic AI nur als Ergänzung. Als Werkzeug, das bestehende Teams unterstützt. In Wahrheit kann die Technologie jedoch Erfahrung komprimieren. Was bisher Seniorität brauchte, also die Fähigkeit, aus fragmentierten Informationen ein kohärentes Bild zu formen, kann ein gut orchestriertes Agentensystem in Teilen replizieren.
Das heißt nicht, dass Menschen überflüssig werden. Aber es heißt, dass sich die Art der benötigten Kompetenz verschiebt. Wer heute Daten zusammenträgt und aufbereitet, wird morgen Agenten konfigurieren, ihre Ergebnisse bewerten und die Ausnahmen und Entscheidungen bearbeiten, die kein Algorithmus lösen kann. Das ist kein Verlust. Es kann sogar ein Gewinn sein. Aber nur, wenn die Organisation diesen Übergang bewusst gestaltet.
Ein Framework hilft bei der Orientierung. Drei strategische Optionen stehen zur Verfügung: Repositionierung, Begrenzung und Reduktion. Repositionierung bedeutet, Beschäftigte in neue Rollen zu entwickeln, die durch Agentic AI erst entstehen. Begrenzung bedeutet, den Einsatz bewusst auf definierte Bereiche zu beschränken und die menschliche Expertise dort zu schützen, wo sie unverzichtbar bleibt. Reduktion ist die dritte Option, und sie ist ehrlich: In manchen Bereichen wird die digitale Belegschaft Kapazitäten ersetzen, die durch die demographischen Entwicklungen auftreten werden.
Die meisten Organisationen werden alle drei Optionen gleichzeitig brauchen. Wer nur auf eine setzt, wird entweder zu langsam oder zu rücksichtslos.
## Wenn Maschinen Entscheidungen vorbereiten, die niemand mehr hinterfragt
Die dritte Veränderung ist die folgenreichste. Agentic AI kann Entscheidungen nicht nur vorbereiten. Sie kann sie in bestimmten Kontexten eigenständig treffen.
Autonomiestufen sind hier der Schlüssel. Am unteren Ende steht der beratende Agent: Er sammelt Informationen und präsentiert Optionen. Ein Mensch entscheidet. Am oberen Ende steht der vollständig autonome Agent: Er analysiert, bewertet, entscheidet und handelt. Dazwischen liegt ein breites Spektrum, und genau in diesem Spektrum spielt sich die Realität ab.
Die Versuchung ist groß, die Autonomie schrittweise hochzudrehen. Wenn der Agent bei den ersten 500 Kreditentscheidungen in 98 Prozent der Fälle richtig lag, warum dann nicht die menschliche Freigabe abschaffen? Die Antwort kennt jeder, der in einem regulierten Umfeld gearbeitet hat: Weil die 2 Prozent Fehler nicht gleichverteilt sind. Sie konzentrieren sich auf genau die Fälle, die komplex, mehrdeutig und kontextsensitiv sind. Also auf die Fälle, die über Existenzen entscheiden.
Menschliche Expertise bleibt bei diesen Entscheidungen unverzichtbar. Das ist keine nostalgische Position. Es ist eine rechtliche Notwendigkeit. Ein falsch positiver Treffer in einer Sicherheitsbehörde hat andere Konsequenzen als ein falsch empfohlenes Produkt in einem Online-Shop.
Was Führungskräfte jetzt brauchen, ist ein klares Governance-Modell für Entscheidungsautonomie. Nicht ein einziges Modell für die gesamte Organisation, sondern ein differenziertes: Welche Entscheidungen darf ein Agent autonom treffen? Wo muss ein Mensch freigeben? Wo darf der Agent nicht einmal empfehlen?
Aus der Praxis mit mehreren KI-Systemen in einem großen Behördenumfeld kann ich sagen: Diese Differenzierung kostet Zeit. Viel Zeit. Aber sie ist die Grundlage dafür, dass Agentic AI nicht zum rechtlichen und Reputationsrisiko wird. Und in einem Bereich, in dem Vertrauen die härteste Währung ist, kann man sich dieses Risiko nicht leisten.
## Was passiert, wenn man nicht handelt
Die drei Veränderungen, autonome Workflows, digitale Belegschaft und automatisierte Entscheidungsfindung, kommen nicht nacheinander. Sie kommen gleichzeitig. Und sie verstärken sich gegenseitig.
Eine Organisation, die Workflows automatisiert, braucht weniger operative Kapazität. Gleichzeitig braucht es mehr Governance-Kompetenz. Und es braucht Menschen, die verstehen, wo die Grenze zwischen sinnvoller Automatisierung und fahrlässiger Delegation verläuft.
Wer jetzt nicht handelt, verliert nicht nur Effizienz. Er verliert Handlungsfähigkeit. Denn die Organisationen, die heute ihre KI-Kompetenz aufbauen, werden morgen die Standards setzen. Und wer Standards setzt, definiert die Spielregeln.
Hierarchische Kulturen erschweren diesen Wandel natürlich. Agentic AI funktioniert am besten, wenn Experimentierräume existieren. Wenn Teams Pilotprojekte starten können, ohne drei Hierarchieebenen um Erlaubnis zu fragen. Das widerspricht dem Selbstverständnis vieler Organisationen und deren risikovermeidenden Kultur. Aber es ist die Realität: Bottom-Up-Innovation und Top-Down-Governance müssen koexistieren. Das ist schwer. Es ist aber machbar.
## Drei Szenarien für die nächsten 36 Monate
Die Zukunft ist nicht binär. Es gibt nicht die eine KI-Zukunft, auf die man sich vorbereiten kann. Drei Szenarien sind plausibel, und eine kluge Strategie bereitet auf alle drei vor.
Im ersten Szenario entwickelt sich Agentic AI als spezialisiertes Werkzeug weiter. Agenten übernehmen klar definierte Aufgaben, bleiben aber unter menschlicher Aufsicht. Das ist die konservative Variante und wahrscheinlich die kurzfristig realistischste.
Im zweiten Szenario entsteht eine augmentierte Arbeitskultur. Menschen und Agenten arbeiten in hybriden Teams zusammen. Jeder Beschäftigte hat einen oder mehrere KI-Assistenten, die seine Arbeit verstärken. Die Organisation wird insgesamt leistungsfähiger, ohne dass massiv Personalveränderungen oder Stellen abgebaut werden.
Im dritten Szenario werden Agenten so leistungsfähig, dass ganze Wertschöpfungsketten ohne menschliche Beteiligung ablaufen. Das ist die disruptive Variante. Sie ist heute noch nicht Realität. Aber sie ist auch nicht mehr Science-Fiction. Dies wird heute in bestimmten Aufgabenbereichen schon getestet und mit überwachtem Lernen weiter ausprobiert.
Das zweite Szenario halte ich für das wahrscheinlichste. Aber wer nur auf dieses eine Szenario plant, macht denselben Fehler wie alle, die 2019 gesagt haben, dass Sprachmodelle ein Nischenthema bleiben.
Was alle drei Szenarien gemeinsam haben: Sie erfordern eine Organisation, die lernt. Nicht eine, die einmal entscheidet und dann umsetzt. Sondern eine, die ihre Strategie vierteljährlich überprüft und anpasst. KI verändert nicht nur einzelne Jobs. Sie verändert die gesamte Arbeitskultur. Und eine Kultur ändert sich nicht per Vorstandsbeschluss. Sie ändert sich durch Erfahrung, durch Reibung und durch Menschen, die bereit sind, alte Gewissheiten aufzugeben. Das ist die eigentliche Führungsaufgabe.
## Von der Analyse zur Umsetzung: Was Du jetzt konkret tun kannst
Die strategische Analyse zeigt: Agentic AI ist kein Projekt, das man irgendwann starten kann. Es ist eine Transformation, die bereits läuft. Die Frage ist, ob Du sie gestaltest oder ob sie Dich gestaltet.
Vier Handlungsfelder verdienen sofortige Aufmerksamkeit.
**Erstes Handlungsfeld: Governance vor Technologie.** Bevor Du den ersten Agenten in Betrieb nimmst, brauchst Du ein Regelwerk. Welche Entscheidungen dürfen automatisiert werden? Wer haftet, wenn ein Agent falsch liegt? Wie wird die Nachvollziehbarkeit sichergestellt? Diese Fragen klingen bürokratisch. Sie sind es auch. Aber sie schützen Dich vor dem Moment, in dem ein autonomer Prozess eine Entscheidung trifft, die Du nicht erklären kannst.
**Zweites Handlungsfeld: Kompetenzaufbau, nicht Technologiekauf.** Die größte Investition ist nicht die Lizenz für eine Agentenplattform. Die größte Investition ist das Wissen Deiner Beschäftigten. Wer versteht, was ein Agent kann und was nicht, trifft bessere Entscheidungen über dessen Einsatz. Wer es nicht versteht, kauft entweder zu viel oder zu wenig. Beides ist teuer. Pilotprojekte mit klarem Lernziel sind hier der richtige Einstieg, nicht Großprojekte mit Leuchtturm-Ambitionen.
**Drittes Handlungsfeld: Erfahrungswissen sichern.** Wenn Agenten Routineaufgaben übernehmen, verschwindet das implizite Wissen, das in diesen Routinen steckt. Der Sachbearbeiter, der seit 15 Jahren Anträge prüft, weiß Dinge, die in keinem Handbuch stehen. Dieses Wissen muss dokumentiert werden, bevor es verloren geht. Nicht als Pflichtübung, sondern als strategische Ressource. Denn genau dieses Wissen ist es, das Agenten brauchen, um vernünftig konfiguriert zu werden.
**Viertes Handlungsfeld: Hybride Strategien statt Entweder-Oder.** Die Versuchung ist groß, sich für ein Szenario zu entscheiden und alles darauf auszurichten. Klüger ist es, flexibel zu bleiben. Eine Multi-Modell-Architektur, die verschiedene KI-Systeme kombiniert, ist robuster als die Abhängigkeit von einem einzigen Anbieter. Techniken wie Retrieval Augmented Generation, also die gezielte Anbindung eigener Datenbestände an KI-Modelle, sichern die Faktenbasis und reduzieren Halluzinationen. Eine Personalstrategie, die sowohl Repositionierung als auch behutsame Weiterentwicklungen vorsieht, ist ehrlicher als das Versprechen, dass niemand in seinem Aufgabenbereichen betroffen ist.
Was all diese Handlungsfelder verbindet: Transformation ist kein einmaliges Projekt. Es ist ein kontinuierlicher Prozess. Wer glaubt, er könne Agentic AI einmal einführen und dann zur Tagesordnung übergehen, unterschätzt die Geschwindigkeit dieser Entwicklung. Die Technologie wird sich in den nächsten 12 Monaten weiterentwickeln, und Deine Governance muss mithalten können. Das erfordert nicht nur technische Kompetenz. Es erfordert organisatorische Lernfähigkeit.
## Fazit
Agentic AI ist keine Zukunftsmusik. Es ist Gegenwartsmusik, und die Melodie ändert sich schneller, als die meisten Organigramme es abbilden können. Die drei Veränderungen, autonome Workflows, digitale Belegschaft und automatisierte Entscheidungsfindung, sind nicht optional. Sie passieren. Die einzige Wahl, die Du hast, ist die zwischen Gestalten und Reagieren.
Mein Rat nach langen Jahren in Organisationen, die Veränderungen eher ertragen als begrüßen: Fang klein an, aber fang jetzt an. Bau Kompetenz auf, bevor Du Technologie kaufst. Und schreib Deine KI-Strategie selbst, bevor es die KI für Dich tut.
## Quick Check: Ist Deine Organisation auf Agentic AI vorbereitet?
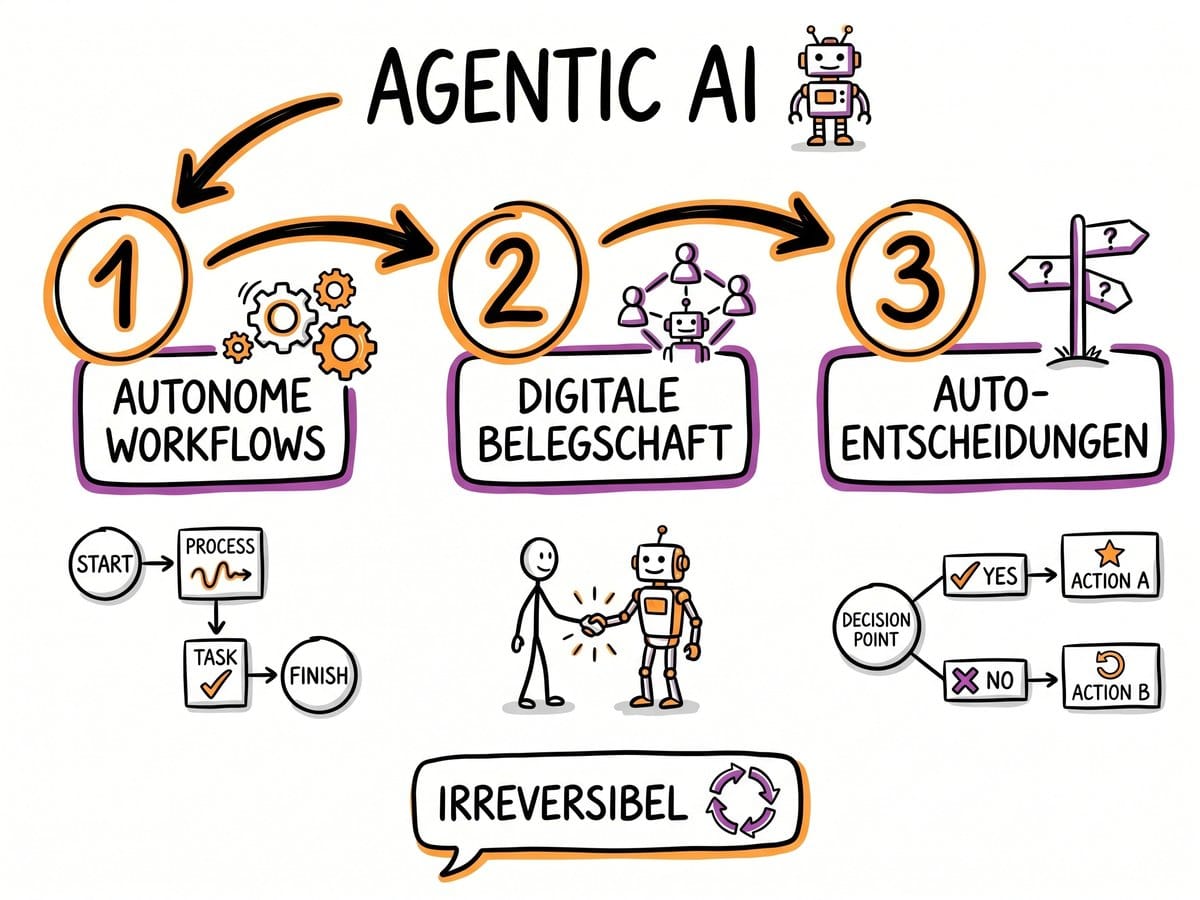
Checkliste für Agentic AI
✅
****Governance-Rahmen**. Prüffrage: Existiert ein dokumentiertes Regelwerk, das Autonomiestufen und rote Linien für KI-Agenten definiert? **Ohne Governance-Rahmen entstehen unkontrollierte Automatisierungsinseln mit Haftungsrisiken.*
✅
****Entscheidungsmatrix**. Prüffrage: Gibt es eine klare Zuordnung, welche Entscheidungen autonom, assistiert oder ausschließlich menschlich getroffen werden? **Die Grenze zwischen sinnvoller Automatisierung und fahrlässiger Delegation muss vorab definiert sein.*
✅
****KI-Kompetenz**. Prüffrage: Haben mindestens 30 Prozent der Führungskräfte eine fundierte Einführung in Agentic AI absolviert? **Fehlende Kompetenz führt zu überhasteten Investitionen oder reflexartiger Ablehnung.*
✅
****Erfahrungswissen**. Prüffrage: Wird implizites Prozesswissen systematisch dokumentiert, bevor Routineaufgaben automatisiert werden? **Ohne dieses Wissen fehlt die Grundlage für eine sinnvolle Agentenkonfiguration.*
✅
****Personalstrategie**. Prüffrage: Enthält die aktuelle Personalplanung konkrete Szenarien für Repositionierung, Begrenzung und Reduktion? **Wer nur auf Ergänzung plant, wird von der Geschwindigkeit der Entwicklung überrollt.*
✅
****Pilotprojekte**. Prüffrage: Laufen mindestens zwei Pilotprojekte mit definierten Lernzielen und Evaluationskriterien? **Ohne praktische Erfahrung bleiben alle Strategiepapiere Theorie.*
✅
****Akzeptanz-Management**. Prüffrage: Werden Beschäftigte aktiv in die Gestaltung der KI-Strategie einbezogen? **Technische Exzellenz ohne organisatorische Akzeptanz erzeugt Widerstand statt Wirkung.*
---
Your Data Isn't Ready for AI Agents by Andreas Lezgus
Most organizations want autonomous data management. Almost none have the foundation it requires.
[Read on Substack](https://substack.lezgus.de/p/your-data-isnt-ready-for-ai-agents?ref=lezgus.de)
### Souveränitäts-Washing entlarven: Was digitale Souveränität wirklich bedeutet
URL: https://www.lezgus.de/souveranitats-washing-entlarven-was-digitale-souveranitat-wirklich-bedeutet/
Last updated: 2026-05-03T08:15:42.000Z
Rechenzentren, Compliance-Siegel, Hochglanzbroschüren, Cloud-Zertifikate und politische Sonntagsreden. Fünf Bausteine, die in fast jeder Präsentation zum Thema digitale Souveränität auftauchen. Warum reicht keiner davon aus, um auch nur eine einzige Behörde tatsächlich unabhängig zu machen?
Der Begriff digitale Souveränität hat Konjunktur. Jeder Cloud-Anbieter trägt ihn vor sich her wie ein Gütesiegel. Jede Strategiepräsentation enthält ihn mindestens dreimal. Und jede politische Grundsatzrede beschwört ihn, als wäre er ein Naturgesetz. Das Problem: Zwischen dem Label und der Realität klafft eine Lücke, die sich mit PowerPoint-Folien nicht schließen lässt.
Wer einige Jahre in öffentlichen Verwaltung arbeitet, kennt dieses Muster. Ein Begriff wird populär. Anbieter adaptieren ihn. Und plötzlich ist alles souverän, was einen deutschen Serverstandort hat. Das ist ungefähr so überzeugend wie ein Fitnessstudio, das Gesundheit verspricht, aber keine Geräte hat.
Dieser Artikel zerlegt den Begriff in seine tatsächlichen Bestandteile. Er zeigt, wo Substanz aufhört und Marketing anfängt. Und er liefert dir einen konkreten Kriterienkatalog, mit dem du Souveränitäts-Washing erkennst, bevor es dich einholt.
## Was digitale Souveränität nicht ist
Beginnen wir mit dem Offensichtlichen. Digitale Souveränität ist kein Serverstandort. Sie ist auch kein Logo auf einer Webseite. Und sie ist definitiv kein Feature, das man dazubuchen kann.
In vielen Vergabeverfahren beobachte ich seit Jahren dasselbe Schauspiel. Ein Anbieter präsentiert seine Cloud-Lösung. Irgendwo auf Folie 12 steht: "DSGVO-konform, Rechenzentrum in Frankfurt." Danach nicken alle. Haken dran. Souverän.
Nur: Was passiert mit den Daten, wenn sie verarbeitet werden? Wer hat operativen Zugriff auf die Infrastruktur? Welche Abhängigkeiten entstehen durch proprietäre Schnittstellen? Und vor allem: Kannst du den Anbieter wechseln, ohne dein halbes IT-Budget für die Migration aufzuwenden?
Diese Fragen stellt kaum jemand. Das ist bequem. Aber es ist nicht souverän.
**Digitale Souveränität ist kein Zustand.** Sie ist eine Fähigkeit. Die Fähigkeit, selbstbestimmt zu handeln, Abhängigkeiten zu erkennen und Alternativen zu haben. Wer diese Fähigkeit nicht aufbaut, kauft ein Etikett. Mehr nicht.
### Das Souveränitäts-Paradox
Hier liegt ein Widerspruch, den die meisten Strategiepapiere elegant umgehen. Vollständige digitale Souveränität würde bedeuten: eigene Hardware, eigene Software, eigene Fachkräfte für alles. Das kann sich kein Staat leisten. Und kein Staat braucht das.
Die ehrliche Frage lautet nicht: "Sind wir souverän?" Sondern: "Bei welchen Systemen und Daten müssen wir souverän sein, und bei welchen reicht ein beherrschbares Risiko?"
Aus langjähriger Praxis weiß ich: Die meisten Organisationen scheuen diese Priorisierung. Sie wollen alles souverän haben, schaffen aber nichts davon konsequent. Das Ergebnis ist eine flächendeckende Mittelmäßigkeit, die niemanden schützt.
Ein risikobasierter Ansatz funktioniert anders. Er sortiert Systeme und Daten nach Kritikalität. Er definiert für jede Stufe konkrete Anforderungen. Und er akzeptiert, dass nicht jedes Bürokommunikationssystem denselben Schutz braucht wie ein System, das personenbezogene Daten verarbeitet oder sicherheitsrelevante Analysen durchführt.
## Fünf Dimensionen, die über Substanz entscheiden
In Diskussionspapieren zur digitalen Souveränität der öffentlichen Verwaltung kristallisieren sich fünf Bewertungsdimensionen heraus. Keine davon ist optional. Alle zusammen ergeben erst das vollständige Bild.
### 1\. Organisatorische Souveränität
Die unterschätzteste Dimension. Organisatorische Souveränität bedeutet: Du hast die Kompetenz, deine IT-Strategie selbst zu steuern. Du kannst Anforderungen formulieren, Angebote bewerten und Verträge gestalten, die deine Interessen schützen.
Klingt selbstverständlich? Ist es nicht.
In der Realität fehlt vielen Behörden genau diese Kompetenz. Die IT-Abteilung administriert, was eingekauft wurde. Die Fachabteilungen bestellen, was der Anbieter empfiehlt. Und die Leitung unterschreibt, was auf dem Tisch liegt. Das ist keine Steuerung. Das ist Verwaltung des Unvermeidlichen.
Organisatorische Souveränität beginnt mit Personal. Mit Fachleuten, die verstehen, was sie einkaufen. Die wissen, welche Klauseln in einem Cloud-Vertrag stehen müssen. Und die im Ernstfall einen Anbieterwechsel durchführen können, ohne dass der Betrieb zusammenbricht.
Wer glaubt, das sei eine reine IT-Frage, hat das Problem nicht verstanden. Organisatorische Souveränität ist eine Führungsaufgabe.
### 2\. Anwendungssouveränität
Hier wird es technisch. Anwendungssouveränität fragt: Kannst du die Software, die du einsetzt, kontrollieren? Hast du Zugang zum Quellcode? Kannst du Änderungen vornehmen oder vornehmen lassen? Oder bist du darauf angewiesen, dass der Hersteller irgendwann ein Update liefert?
**Open Source ist hier ein Hebel.** Nicht der einzige. Aber ein gewichtiger. Offener Quellcode bedeutet nicht automatisch Souveränität. Aber er bedeutet: Du kannst prüfen, was die Software tut. Du kannst sie anpassen. Und du kannst sie notfalls selbst betreiben oder einen anderen Dienstleister damit beauftragen.
Proprietäre Software schließt diese Optionen aus. Sie erzeugt Abhängigkeiten, die mit jedem Update wachsen. Und sie macht den Wechsel teurer, je länger du wartest. Das ist kein Bug. Das ist das Geschäftsmodell.
Offene Standards spielen eine ähnliche Rolle. Wenn deine Daten in einem proprietären Format gespeichert sind, gehören sie dir nur auf dem Papier. In der Praxis gehören sie dem Format. Und damit dem Anbieter.
### 3\. Datensouveränität
Die Königsdisziplin. Datensouveränität bedeutet: Du bestimmst, wer auf deine Daten zugreift, wo sie gespeichert werden und wie sie verarbeitet werden.
In einem großen Behördenumfeld habe ich erlebt, wie ein Plattformanbieter eine umfangreiche Ontologie für Datenverknüpfungen anbot. Das System konnte beeindruckende Analysen erstellen. Personen, Beziehungen, Muster. Alles in einer einzigen Plattform. Alles schön visualisiert.
Was kaum jemand fragte: Was passiert, wenn wir diese Plattform wieder verlassen wollen? Die Antwort war ernüchternd. Die Datenmodelle waren so tief in die Plattform integriert, dass eine Migration praktisch einem Neuaufbau gleichkam. Das ist kein Zufall. Das ist Lock-in by Design.
Datensouveränität erfordert deshalb klare Regeln. Jeder Datensatz braucht eine Klassifizierung nach Schutzbedarf. Personenbezogene Daten, erst recht solche, die Menschen kategorisieren und klassifizieren, erfordern besondere Sorgfalt. Nicht nur aus Datenschutzgründen. Sondern weil die Verfassung es verlangt.
Verfassungsrechtlich konforme Datenkennzeichnung ist keine bürokratische Übung. Sie ist die Voraussetzung dafür, dass Daten rechtsstaatlich genutzt werden können. Wer das als lästige Pflicht behandelt, hat den Rechtsstaat nicht als Betriebssystem verstanden, sondern als optionales Plugin.
### 4\. Betriebssouveränität
Kannst du deine IT-Systeme selbst betreiben? Oder bist du auf einen einzigen Anbieter angewiesen, der den Schlüssel zum Maschinenraum hat?
Betriebssouveränität heißt nicht, alles selbst zu machen. Sie heißt: Du hast die Wahl. Du kannst den Betrieb intern organisieren, an einen Dienstleister vergeben oder zwischen Dienstleistern wechseln. Ohne Unterbrechung. Ohne Datenverlust. Ohne sechs Monate Migrationsphase.
Das klingt trivial. Aber teste es einmal in der Praxis. Versuche, eine gewachsene IT-Landschaft von einem Betreiber zum anderen zu migrieren. Du wirst feststellen: Die technischen Hürden sind oft beherrschbar. Die vertraglichen sind es nicht. Kündigungsfristen, Datenherausgabe, Schnittstellendokumentation. Alles Punkte, die beim Vertragsschluss niemand ernst genommen hat. Und die beim Wechsel plötzlich zum Hindernis werden.
Mein Rat nach Jahrzehnten in solchen Projekten: Die Exit-Strategie gehört in den ersten Vertragsentwurf. Nicht in die Schublade.
### 5\. Infrastruktursouveränität
Die physische Ebene. Wo stehen die Server? Wem gehören sie? Welchem Recht unterliegen sie?
Das ist die Dimension, auf die sich die meisten Anbieter konzentrieren. "Rechenzentrum in Deutschland" steht in jeder Broschüre. Aber ein deutsches Rechenzentrum hilft wenig, wenn der Betreiber einem Konzern gehört, der dem CLOUD Act unterliegt. Dann kann eine ausländische Behörde unter bestimmten Umständen Zugriff auf die Daten verlangen, unabhängig davon, wo der Server steht.
Infrastruktursouveränität ist deshalb mehr als Geografie. Sie umfasst die gesamte Lieferkette: Hardware, Firmware, Netzwerkkomponenten. Und sie erfordert Transparenz darüber, wer an welcher Stelle Zugriff hat.
Keine Behörde kann die gesamte Hardware-Lieferkette kontrollieren. Aber jede Behörde kann verlangen, dass die Risiken in dieser Kette transparent gemacht werden. Und darauf basierend entscheiden, welches Risiko akzeptabel ist.
## Souveränitäts-Washing erkennen: Die Warnsignale
Jetzt wird es praktisch. Wie erkennst du, ob ein Anbieter echte Souveränität bietet oder ob du es mit Souveränitäts-Washing zu tun hast?
Hier sind die häufigsten Warnsignale, die mir in über vier Jahrzehnten IT-Praxis begegnet sind.
**Das Standort-Argument als Allheilmittel.** Wenn "Rechenzentrum in Deutschland" die erste und einzige Antwort auf Souveränitätsfragen ist, fehlt der Rest. Standort ist eine notwendige, aber keine hinreichende Bedingung.
**Fehlende Exit-Strategie.** Frage den Anbieter: "Was passiert, wenn wir kündigen? In welchem Format bekommen wir unsere Daten zurück? Wie lange dauert die Migration?" Wenn die Antworten vage sind, hast du dein Warnsignal.
**Proprietäre Schnittstellen ohne offene Alternativen.** Jede Schnittstelle, die nur mit diesem einen Anbieter funktioniert, ist ein Baustein im Lock-in-Gebäude. Offene APIs und standardisierte Formate sind das Gegenmittel.
**Intransparente Unterauftragnehmer.** Wer betreibt tatsächlich die Infrastruktur? Wer hat Zugriff auf die Verwaltungskonsole? Wenn du diese Fragen nicht beantworten kannst, kontrollierst du nichts.
**Keine Quellcode-Einsicht.** Bei sicherheitsrelevanten Anwendungen muss der Quellcode prüfbar sein. "Vertraue uns" ist keine Sicherheitsstrategie. Es ist ein Vertrauensvorschuss, den sich niemand leisten sollte, der Verantwortung für öffentliche Daten trägt.
### Der Plattform-Sog
Besonders tückisch ist das, was ich den Plattform-Sog nenne. Ein Anbieter beginnt mit einer einzelnen Anwendung. Vielleicht einer Analyseplattform. Die funktioniert gut. Also kommen weitere Module dazu. Dann ein Data Lake. Dann Schnittstellen zu anderen Systemen. Dann eigene Entwicklungswerkzeuge.
Nach drei Jahren bist du nicht mehr Kunde. Du bist Bewohner eines geschlossenen Ökosystems. Und der Auszug kostet mehr als der Einzug.
In der Praxis habe ich erlebt, wie Plattformen umfangreiche Ontologien und Datenmodelle anbieten, die auf den ersten Blick faszinierend wirken. Personen, Objekte, Beziehungen, alles verknüpft, alles durchsuchbar. Aber die Data-Pipelines, die diese Verknüpfungen herstellen, müssen durch eigene Fachexperten entwickelt werden. Und genau dort entsteht das tiefe Wissen, das an die Plattform gebunden ist. Nicht an deine Organisation.
Der Sog funktioniert, weil er schleichend ist. Jeder einzelne Schritt ist rational begründbar. Aber die Summe aller Schritte erzeugt eine Abhängigkeit, die sich rational kaum noch auflösen lässt.
Dagegen hilft nur eins: Von Anfang an in modularen Architekturen denken. Jede Komponente muss austauschbar sein. Nicht theoretisch. Praktisch. Und das muss regelmäßig getestet werden.
## Der ethische Blindfleck
Über ein Thema wird bei digitaler Souveränität selten gesprochen. Aber es gehört dazu. Denn Souveränität ohne ethische Leitplanken ist nur Macht ohne Richtung.
Wenn Plattformen es ermöglichen, Menschen umfassend zu klassifizieren und in Beziehungsnetzwerke einzuordnen, stellt sich nicht nur die technische Frage nach der Datenhaltung. Es stellt sich die Frage: Dürfen wir das? Und wenn ja, unter welchen Bedingungen?
Die verfassungsrechtlichen Anforderungen an solche Systeme sind hoch. Das Bundesverfassungsgericht hat klare Grenzen gezogen. Aber Technik bewegt sich schneller als Rechtsprechung. Und Anbieter liefern Funktionen, die rechtlich noch nicht durchdekliniert sind.
Souveränität bedeutet in diesem Kontext auch: die Fähigkeit, Nein zu sagen. Nicht alles einzusetzen, was technisch möglich ist. Sondern nur das, was rechtsstaatlich vertretbar ist.
Das ist keine Schwäche. Das ist ein Qualitätsmerkmal. Eines, das totalitäre Regime nicht kennen. Und das freiheitliche Demokratien verteidigen müssen. Auch in der IT.
## Europäische Alternativen: Möglich, aber nicht mühelos
Ein Gegenargument höre ich oft: "Es gibt doch gar keine europäischen Alternativen. Wir müssen nehmen, was der Markt bietet." Das stimmt nicht. Aber die Alternativen erfordern Arbeit.
Open-Source-Lösungen existieren für nahezu jeden Anwendungsbereich. Von Betriebssystemen über Office-Suiten bis zu Analysewerkzeugen. Europäische Cloud-Anbieter bauen ihre Kapazitäten aus. Und Initiativen wie Gaia-X versuchen, einen Rahmen für souveräne Cloud-Infrastrukturen zu schaffen.
Aber niemand sollte so tun, als wäre der Umstieg ein Spaziergang. Open-Source-Software erfordert interne Kompetenz für Betrieb und Weiterentwicklung. Europäische Alternativen haben manchmal weniger Funktionen als die etablierten Produkte. Und der organisatorische Wandel, der mit einem Wechsel einhergeht, wird regelmäßig unterschätzt.
Trotzdem ist der Weg gangbar. Entscheidend ist, ihn nicht als alles-oder-nichts-Entscheidung zu behandeln. Ein schrittweiser Ansatz funktioniert besser. Beginne mit unkritischen Systemen. Sammle Erfahrungen. Baue Kompetenz auf. Und erweitere den Souveränitätsbereich dann schrittweise auf kritischere Systeme.
Wer wartet, bis die perfekte europäische Alternative existiert, wartet ewig. Und bindet sich in der Zwischenzeit immer tiefer an das bestehende Ökosystem.
### Rechtliche Gestaltung als Pflicht
Ein Punkt wird bei europäischen Alternativen oft vergessen: Die rechtliche Gestaltung muss parallel zur technischen Umsetzung laufen. Es reicht nicht, eine europäische Software einzusetzen. Die Verträge, die Nutzungsbedingungen, die Datenverarbeitungsvereinbarungen müssen den Souveränitätsanforderungen entsprechen.
Das klingt nach Juristenarbeit. Ist es auch. Aber IT-Führungskräfte müssen diese Arbeit anstoßen und begleiten. Denn die Juristen können nur gestalten, was die IT-Seite als Anforderung formuliert. Wer keine Anforderungen stellt, bekommt Standardverträge. Und Standardverträge sind im Interesse des Anbieters formuliert. Nicht in deinem.
## Die Wechselkosten-Falle
Kommen wir zum härtesten Argument gegen echte Souveränität: den Kosten.
Technologischer Lock-in und hohe Wechselkosten sind kein Zufall. Sie sind Teil des Geschäftsmodells. Jede Integration, jede Anpassung, jede Schulung erhöht die Bindung. Nach fünf Jahren rechnet sich ein Wechsel kaum noch. Nach zehn Jahren ist er praktisch ausgeschlossen.
Das ist die Rechnung, die viele IT-Entscheider nicht machen. Sie vergleichen die jährlichen Lizenzkosten verschiedener Anbieter. Aber sie rechnen nicht die Wechselkosten ein, die entstehen, wenn sie nach Jahren den Anbieter tauschen wollen.
Eine ehrliche Kostenbetrachtung sieht so aus:
- Laufende Kosten für Lizenzen und Betrieb
- Kosten für die Integration in die bestehende Landschaft
- Kosten für den Kompetenzaufbau beim Personal
- Geschätzte Kosten für einen vollständigen Anbieterwechsel
- Kosten für den Parallelbetrieb während der Migration
Wer die letzten drei Punkte ignoriert, kauft billig ein und zahlt teuer drauf.
Ich habe in meiner Laufbahn Migrationen erlebt, die doppelt so lange dauerten und dreimal so viel kosteten wie geplant. Nicht weil die Technik versagte. Sondern weil die Abhängigkeiten tiefer reichten als angenommen. Datenformate, die sich nicht konvertieren ließen. Schnittstellen, die undokumentiert waren. Prozesse, die so eng an die alte Plattform gebunden waren, dass sie komplett neu gestaltet werden mussten.
Die Lektion daraus: **Wechselkosten sind keine Überraschung. Sie sind eine planbare Größe.** Aber nur, wenn du sie von Anfang an einplanst.
## Vom Schlagwort zur Strategie
Genug Analyse. Was folgt daraus für die Praxis?
### Schritt 1: Bestandsaufnahme der Abhängigkeiten
Bevor du über Souveränität redest, musst du wissen, wo du stehst. Welche Systeme betreibst du? Wer betreibt sie tatsächlich? Welche Daten liegen wo? Und welche Abhängigkeiten bestehen?
Diese Bestandsaufnahme ist keine einmalige Übung. Sie muss regelmäßig aktualisiert werden. Denn Abhängigkeiten wachsen. Stillschweigend. Kontinuierlich.
### Schritt 2: Risikobasierte Priorisierung
Nicht alles muss souverän sein. Aber alles muss bewertet werden. Sortiere deine Systeme und Daten in Kritikalitätsstufen. Definiere für jede Stufe, welche Souveränitätsanforderungen gelten. Und setze dort an, wo das Risiko am höchsten ist.
Ein Bürokommunikationssystem hat andere Anforderungen als eine Plattform für sicherheitsrelevante Datenanalysen. Diese Unterscheidung muss in der Strategie sichtbar sein.
### Schritt 3: Vertragliche Absicherung
Jeder neue Vertrag mit einem IT-Dienstleister sollte Souveränitätsklauseln enthalten. Datenportabilität, Schnittstellendokumentation, Exit-Unterstützung, Zugriffstransparenz. Das sind keine Luxusforderungen. Das sind Mindestanforderungen.
Die Vergabestellen müssen diese Anforderungen kennen und umsetzen können. Das erfordert Schulung. Und es erfordert den Willen, Verhandlungen nicht beim günstigsten Preis zu beenden, sondern beim besten Gesamtpaket.
### Schritt 4: Kompetenzaufbau
Souveränität ohne Kompetenz ist eine Illusion. Du brauchst Menschen, die Architekturen bewerten, Verträge verhandeln und Migrationen planen können. Diese Menschen auszubilden oder zu gewinnen ist die wichtigste Investition. Keine Software kann fehlendes Know-how ersetzen.
In vielen Behörden höre ich: "Wir finden keine Leute." Das stimmt oft. Aber es ist kein Grund, die Hände in den Schoß zu legen. Es ist ein Grund, die vorhandenen Fachkräfte besser einzusetzen, Weiterbildung ernst zu nehmen und Arbeitsbedingungen zu schaffen, die Kompetenz anziehen statt vertreiben.
### Schritt 5: Regelmäßige Überprüfung
Souveränität ist kein Projekt mit Enddatum. Sie ist ein Dauerzustand, der gepflegt werden muss. Abhängigkeiten verändern sich. Anbieter werden aufgekauft. Technologien veralten. Was heute souverän ist, kann morgen ein Risiko sein.
Ein jährlicher Souveränitäts-Check, gekoppelt an die IT-Strategie, hält das Thema auf der Agenda. Ohne regelmäßige Überprüfung versandet jede noch so gute Anfangsstrategie im Tagesgeschäft.
## Quick Check: Digitale Souveränität in der Praxis
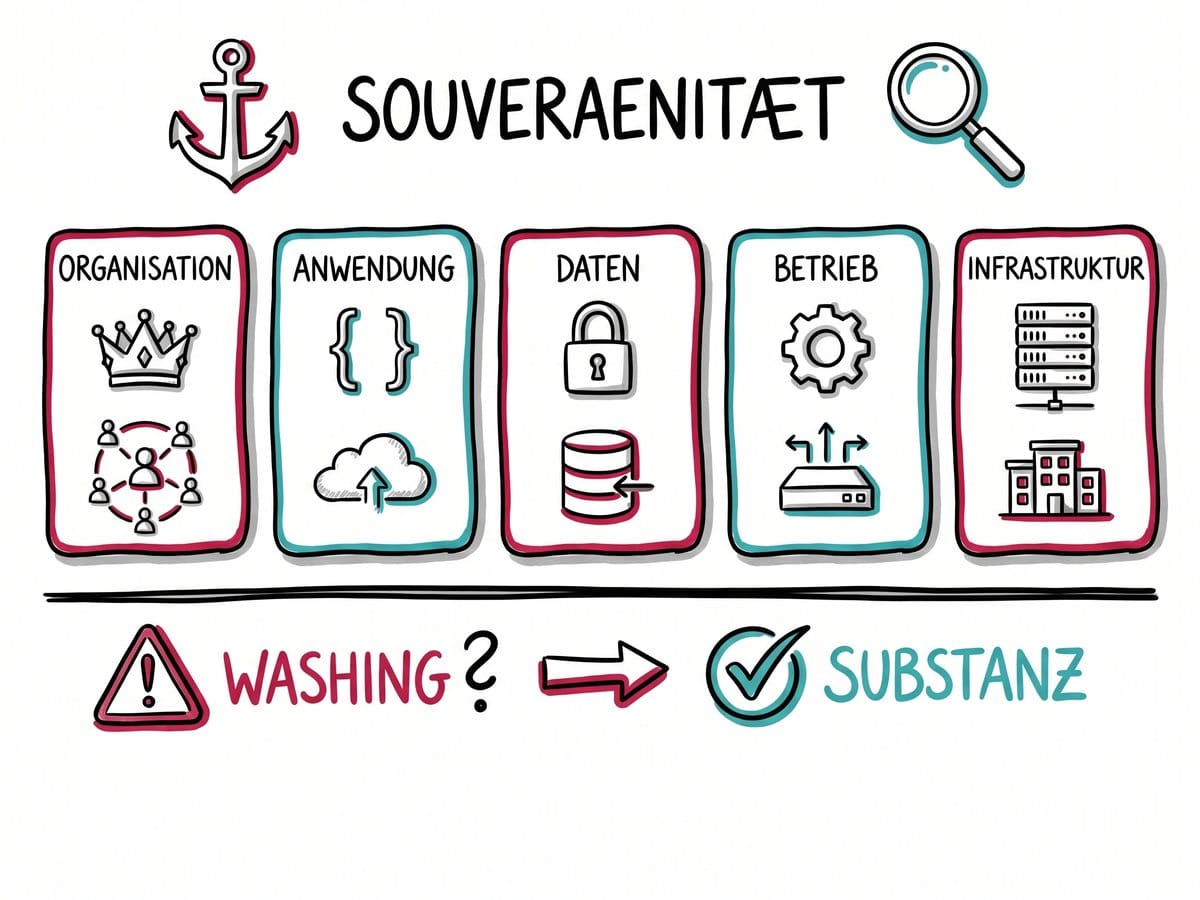
✅
****Datenportabilität**. Prüffrage: Können alle Daten in offenen Formaten exportiert werden? Proprietäre Formate erzeugen stille Abhängigkeit, die erst beim Wechsel sichtbar wird.
✅
****Anbieterwechsel**. Prüffrage: Liegt eine dokumentierte Exit-Strategie mit realistischem Zeitplan vor? Ohne Exit-Plan wird jeder Wechsel zum unkalkulierbaren Risiko.
✅
****Quellcode-Zugang**. Prüffrage: Ist der Quellcode sicherheitsrelevanter Anwendungen prüfbar? Ohne Einsicht gibt es keine unabhängige Sicherheitsbewertung.
✅
****Unterauftragnehmer**. Prüffrage: Ist die vollständige Betreiberkette dokumentiert und vertraglich geregelt? Jeder unbekannte Unterauftragnehmer ist ein potenzielles Einfallstor.
✅
****Personalkapazität**. Prüffrage: Verfügt die Organisation über Fachkräfte, die Architektur und Verträge eigenständig bewerten können? Ohne eigene Kompetenz ist jede Souveränitätsstrategie ein Luftschloss.
✅
****Datenkennzeichnung**. Prüffrage: Werden alle Datensätze nach Schutzbedarf und Rechtsgrundlage klassifiziert? Verfassungskonforme Nutzung erfordert lückenlose Kennzeichnung.
✅
****Lieferanten-Transparenz**. Prüffrage: Ist die gesamte Lieferkette von Hardware bis Software dokumentiert? Risiken in der Lieferkette wirken sich direkt auf die Gesamtsouveränität aus.
## Wer verantwortet, entscheidet
Digitale Souveränität ist unbequem. Sie kostet Geld, bindet Personal und erzwingt Entscheidungen, die kurzfristig teurer sind als der bequeme Weg. Aber der bequeme Weg hat einen Preis, der erst sichtbar wird, wenn es zu spät ist.
Die Frage ist nicht, ob wir uns digitale Souveränität leisten können. Die Frage ist, ob wir es uns leisten können, darauf zu verzichten. In einer Welt, in der geopolitische Spannungen zunehmen, Lieferketten fragil sind und Daten zum strategischen Rohstoff werden, ist Abhängigkeit keine Sparmaßnahme. Sie ist ein Sicherheitsrisiko.
Souveränitäts-Washing zu entlarven ist dabei nur der erste Schritt. Der zweite ist, die eigenen Anforderungen so klar zu formulieren, dass kein Anbieter sich dahinter verstecken kann. Und der dritte ist, den Mut zu haben, Nein zu sagen, wenn das Angebot die Anforderungen nicht erfüllt. Auch wenn es das billigste ist. Auch wenn der Zeitdruck groß ist. Auch wenn alle anderen es kaufen.
Das ist Führung. Nicht das Wiederholen von Buzzwords. Nicht das Abhaken von Zertifikaten. Sondern das bewusste Gestalten von Handlungsfähigkeit.
Oder, etwas kürzer: Nicht alles, was technisch möglich ist, ist auch rechtsstaatlich erlaubt. Und nicht alles, was sich souverän nennt, ist es auch.
### Warum Ihre KI-Strategie drei blinde Flecken hat
URL: https://www.lezgus.de/warum-ihre-ki-strategie-drei-blinde-flecken-hat/
Last updated: 2026-07-05T13:08:59.000Z
KI-Agenten, digitale Souveränität und „Vibe Coding“ wachsen gerade zusammen – und das wird für IT-Verantwortliche im öffentlichen Sektor schnell zum Sturm. Hier ist, was in vielen Strategien fehlt.
## Die unangenehme Rechnung
Eine Vielzahl der Organisationen haben Hinweise darauf, dass nicht genehmigte KI-Agenten in ihrer Umgebung laufen. Gleichzeitig kleben Anbieter das Etikett „KI-Agent“ auf alles – von einfacher Workflow-Automatisierung bis zu klassischem Machine Learning. Das Ergebnis: Goldgräberstimmung trifft auf Organisationen, die dafür noch längst nicht bereit sind.
Aber das ist nur eine von drei Bruchlinien, die ich gerade entstehen sehe. Und gefährlich ist nicht eine einzelne davon – sondern wie sie sich gegenseitig verstärken.
#### Bruchlinie 1: KI-Agenten sind schneller als die Regulierung
Regierungen weltweit verbinden ihre KI-Ziele immer stärker mit Agenten: dialogorientierte Services, teilautonome Entscheidungshilfe, Automatisierung mit Bürgerkontakt – die Anwendungsfälle wachsen schneller als die Governance-Regeln.
Hier kommt die unbequeme Wahrheit: Die meisten Organisationen finden, KI-Agenten sollten nur von IT-Abteilungen gebaut werden – nicht von Endanwendern. Nur ein geringer Teil denkt überhaupt über vollständig autonome Agenten nach. Trotzdem nimmt die Einführung weiter zu.
Diese Lücke zwischen Anspruch und Kontrolle erzeugt reale Risiken. Wenn ein zu wenig regulierter KI-Agent bei einer Bürgerinteraktion einen Fehler macht, verliert nicht der Hersteller an Glaubwürdigkeit – sondern die Behörde. Und im öffentlichen Sektor ist Vertrauen keine „weiche“ Kennzahl. Es ist die Grundlage, auf der alles läuft.
Diskutiert wird über Ausfälle staatlicher Dienstleistungen, die auf zu wenig regulierte KI-Agenten-Interaktionen zurückzuführen sind. Das ist keine theoretische Warnung, sondern die absehbare Folge davon, schneller zu sein als die eigene Governance.
Die Frage, die in Meetings kaum jemand stellt:
„Ist das wirklich ein KI-Agent – oder nur umbenannte Automatisierung, die wir schon haben?“
### Bruchlinie 2: Souveränität als strategische Illusion
Digitale Souveränität ist in fast jeder Region zu einem politischen Top-Thema geworden. Doch aktuelle Schätzungen gehen davon aus, dass bis 2028 60 % der staatlichen Souveränitätsinitiativen ihre Ziele verfehlen werden. Der Grund: unrealistische Zeitpläne und Kostenannahmen, die eher aus politischen Zyklen kommen als aus technischer Realität.
Viele Souveränitätsprogramme fokussieren sehr eng auf Datenstandort und einfache Cloud-Dienste. Die tieferen Risiken entlang ganzer Technologie-Stacks – von Arbeitsplatz-Tools über KI-Plattformen bis zu SaaS-Anwendungen – bleiben oft unsichtbar.
Ich nenne das „Sovereignty Washing“: Lokale Anbieter werben mit souveränen Lösungen, nutzen aber in ihrer Lieferkette weiterhin Hyperscaler. Die Abhängigkeit ist nicht weg – sie sitzt nur eine Ebene tiefer.
Digitale Souveränität ist kein Projekt, das man in einem Haushaltsjahr „fertig“ macht. Es ist eine strategische Haltung, die Jahre braucht. Wer sie wie eine Checkliste behandelt, verbrennt Geld und politisches Kapital – und reduziert das tatsächliche Risiko kaum.
### Bruchlinie 3: Vibe Coding erzeugt unsichtbare Schulden
Das ist die Bruchlinie, die am wenigsten Aufmerksamkeit bekommt: Vibe Coding. Gemeint ist: Anwendungen werden per natürlicher Sprache „zusammengebaut“ – über Prompts – ohne klassisches Programmieren. Das gewinnt schnell an Fahrt. Eine Vielzahl an Behörden planen, ihre Budgets zur Modernisierung von Anwendungen zu erhöhen. Die meisten nutzen bereits Low-Code-Plattformen. Vibe Coding ist der nächste logische Schritt.
Für Prototypen und Innovationslabore ist das sinnvoll. Die Gefahr beginnt, wenn aus Experimenten schleichend Produktionssysteme werden.
Ein vibe-codierter Prototyp funktioniert in der Demo – aber er kennt keine Architekturstandards, keine Sicherheitsrichtlinien und keine Integrationsanforderungen. Wenn Budgetdruck und kurze Wahlzyklen diesen Prototyp in den Betrieb drücken, entsteht technische Schuld, die Jahre dauert, um sie wieder abzubauen.
### Wo die drei Bruchlinien zusammenlaufen
Was mir dabei wirklich Sorgen macht: Diese drei Trends sind nicht getrennt – sie konvergieren.
Ein schlecht regulierter KI-Agent auf einer nicht-souveränen Plattform, gebaut per Vibe Coding und ohne architektonische Aufsicht – das ist kein hypothetisches Szenario. Das ist die Richtung, in die der Trend gerade zeigt.
Die Rolle staatlicher CIOs verschiebt sich damit: von Technologie-Verwaltern hin zu strategischen Risikomanagern. Erfolg heißt, Innovation und Widerstandsfähigkeit auszubalancieren – und lokale Ökosysteme aufzubauen, die Abhängigkeiten von ausländischen Technologien abfedern.
### Der Weg nach vorn
Diese Bruchlinien lassen sich adressieren – nicht durch Panik und nicht durch pauschale Ablehnung. Sondern durch bewusste Governance.
#### Für KI-Agenten:
Führen Sie vorbeugende Risikoanalysen durch, bevor ein Agent produktiv geht. Fordern Sie von jedem Anbieter Transparenz, Beobachtbarkeit (Observability) und manuelle Fallback-Mechanismen. Oft liefern bestehende Automatisierungslösungen in Ihrer Cloud ähnliche Ergebnisse – mit deutlich weniger Risiko.
#### Für Souveränität:
Kartieren Sie direkte und indirekte ausländische Abhängigkeiten über Ihre Kern-Stacks hinweg. Priorisieren Sie nach Risiko, Kosten und strategischem Wert. Ziel ist selten vollständige Entkopplung – sondern die Fähigkeit, im Krisenfall handlungsfähig zu bleiben.
#### Für Vibe Coding:
Begrenzen Sie den Einsatz zunächst auf nicht-kritische Experimente. Passen Sie Ihren Softwareentwicklungsprozess so an, dass Vibe-Coding-Risiken ausdrücklich adressiert werden. Verlangen Sie menschliches Review und architektonische Freigabe, bevor irgendetwas produktiv geht.
## Quick Check: Blinde Flecken in der KI-Strategie
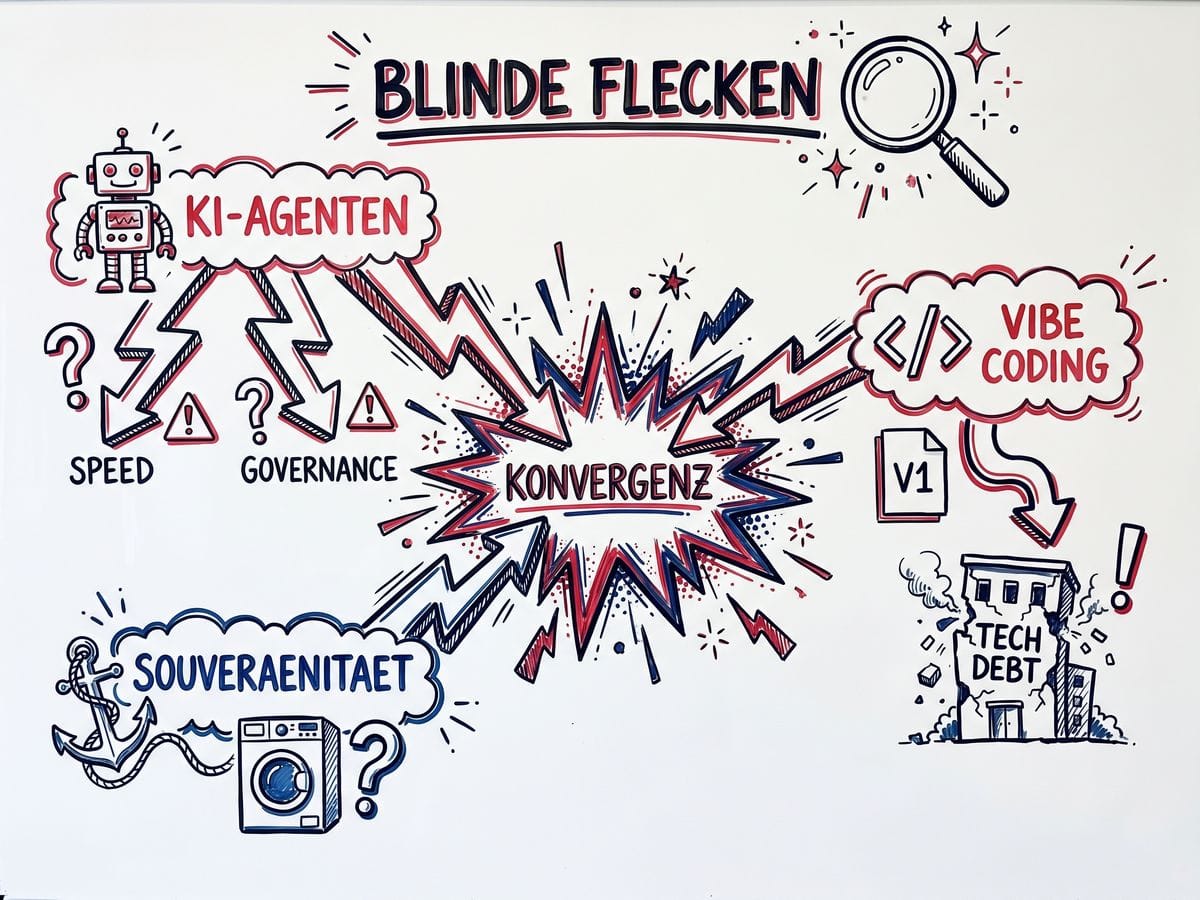
Checkliste Blinde Flecken
✅ Prüfen Sie Ihre Organisation auf **nicht genehmigte KI-Agenten** – die Zahl wird Sie vermutlich überraschen
✅ Fragen Sie jeden KI-Anbieter: „Ist das wirklich agentisch – oder nur **umbenannte Automatisierung**, die wir bereits besitzen?“
✅ Kartieren Sie **Lieferketten-Abhängigkeiten** mindestens zwei Ebenen tief – dort versteckt sich „Sovereignty Washing“
✅ Definieren Sie klare **Grenzen für Vibe Coding**: Was darf prototypisiert werden, was braucht Architektur-Review?
✅ Verlangen Sie **menschliche Freigabe**, bevor eine KI-generierte Anwendung in Produktion geht
✅ Setzen Sie eine **vierteljährliche Review** technischer Schulden auf die Agenda Ihres IT-Steuerungsgremiums
✅ Führen Sie ein **Souveränitätsregister**, das dokumentiert, wo Ihre Daten tatsächlich liegen – nicht wo sie liegen sollten
---